
分布式数据库期末复习
老师给的题库范围,题库源自 分布式数据库系统原理(英文4版)
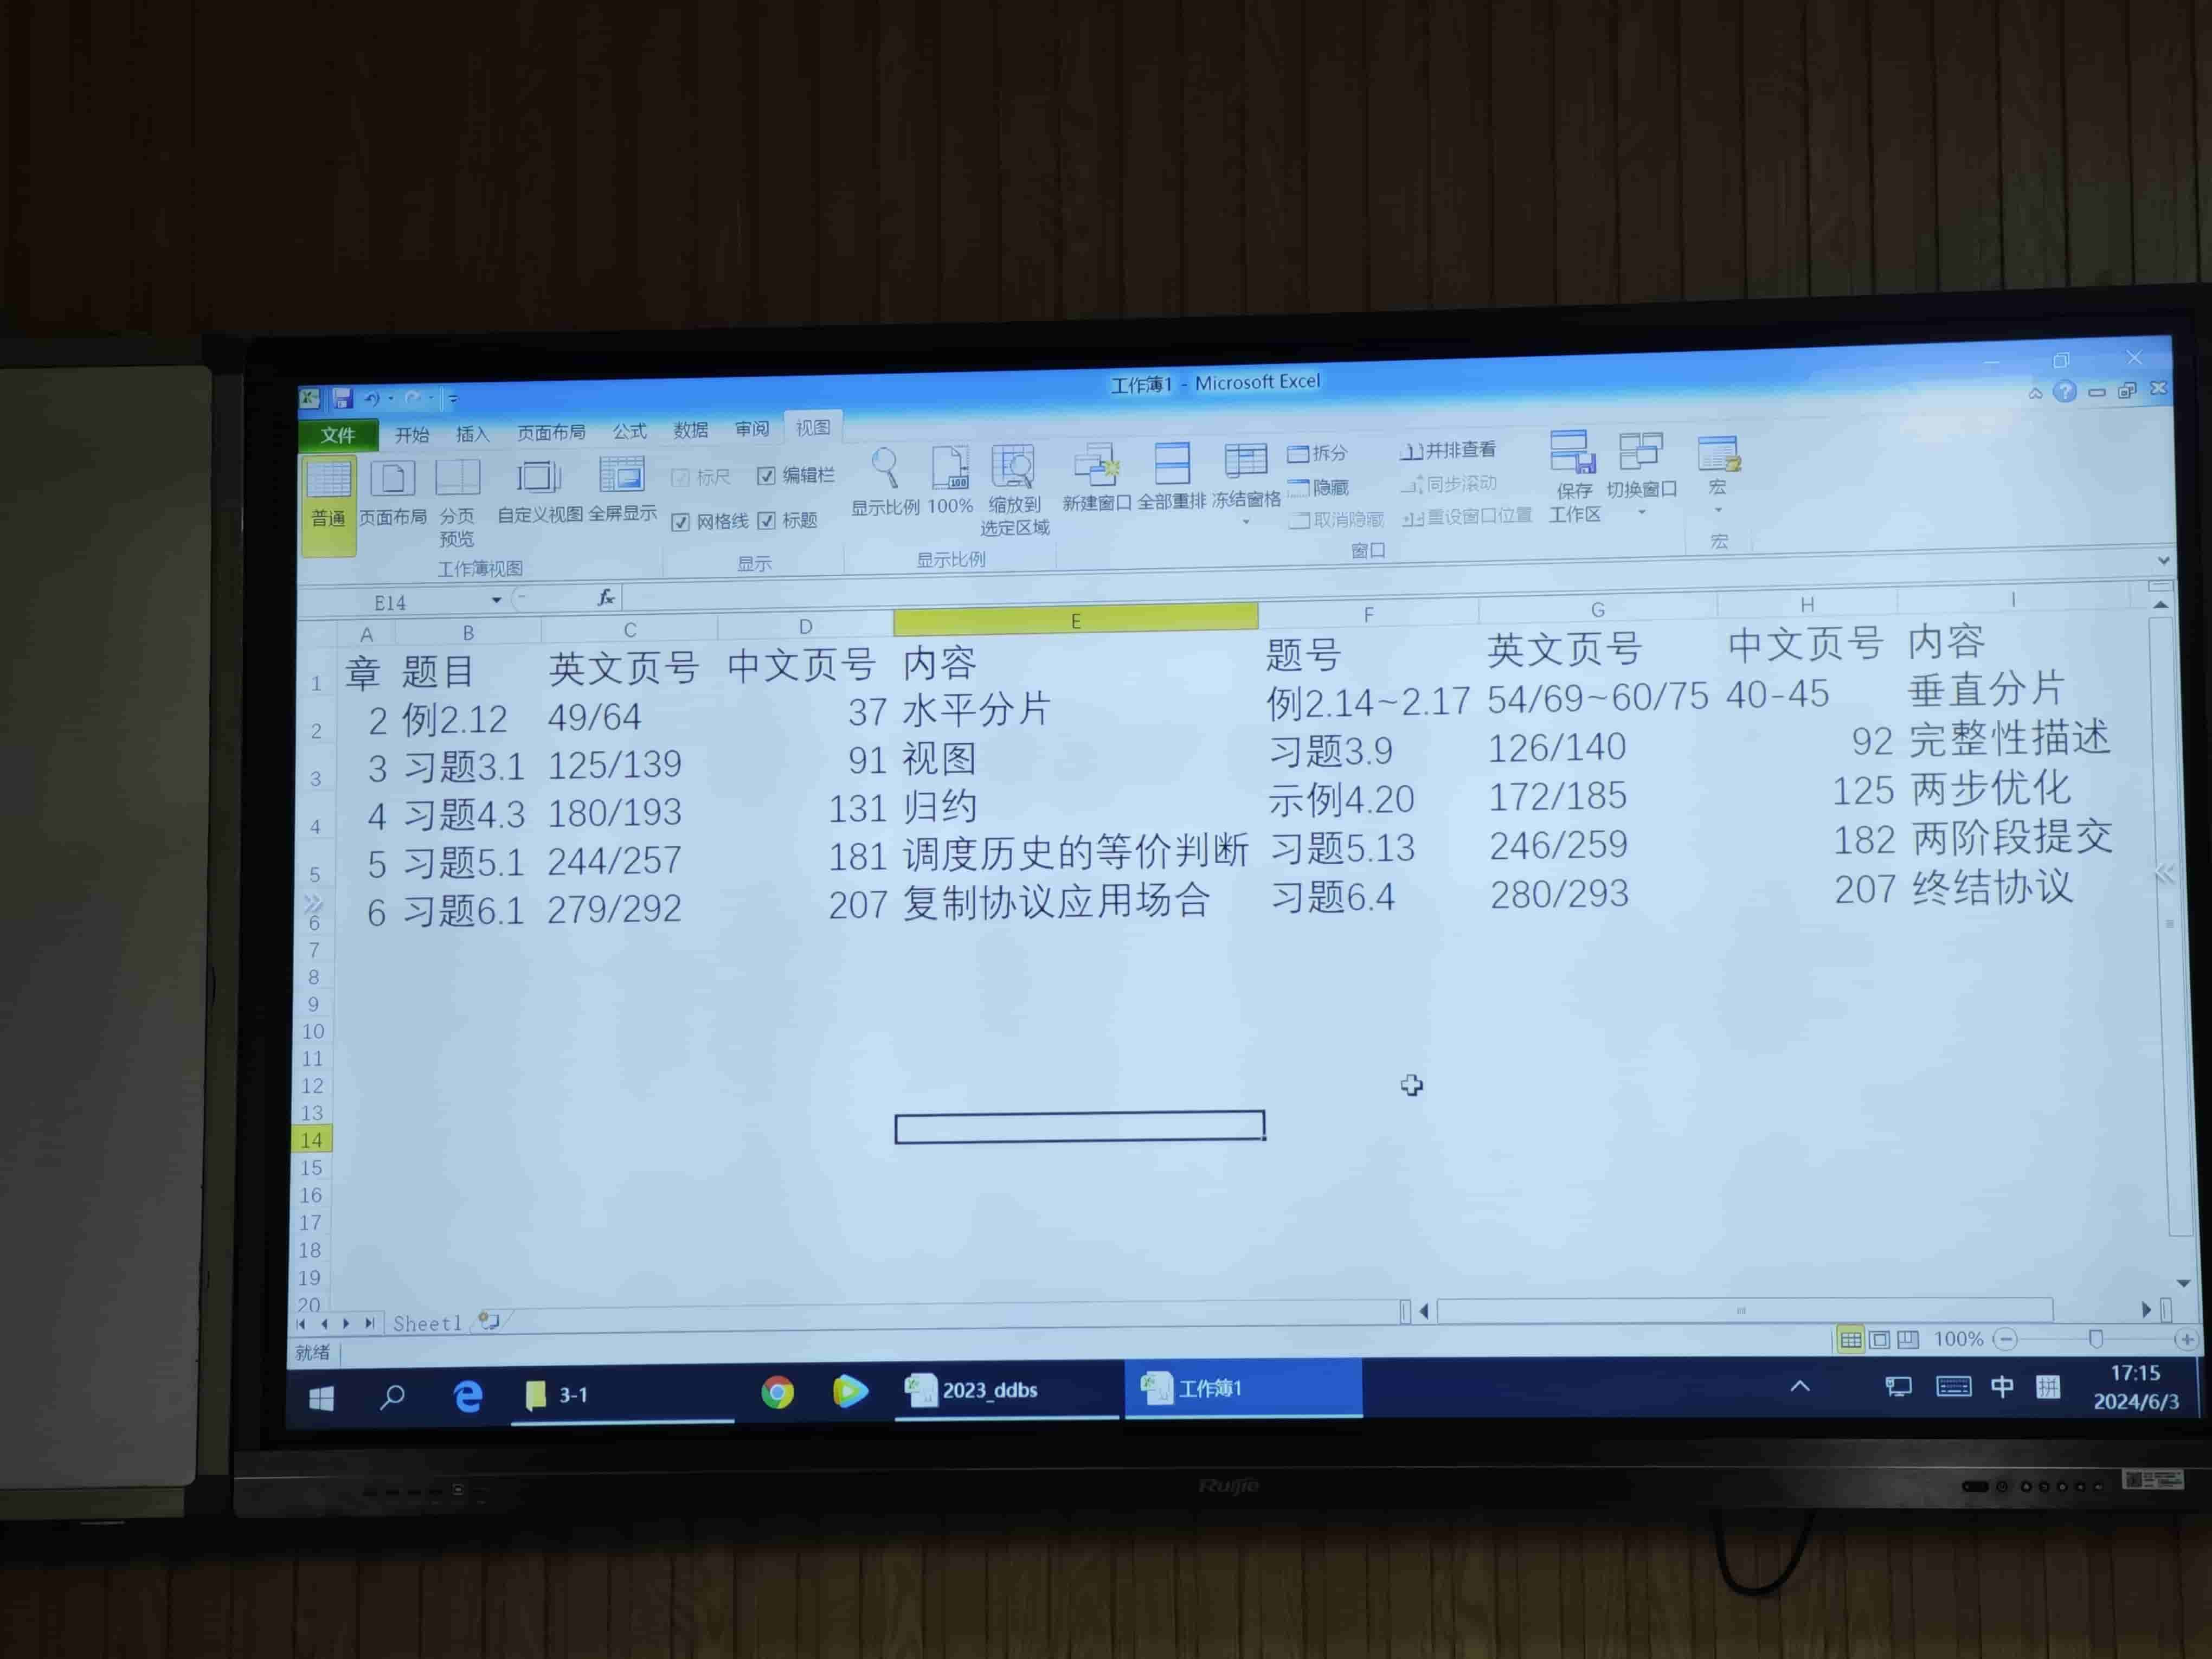
但是这玩意给的都是英文题,中文的第四版PDF还找不见,那只能边复习边翻译一下了
1 水平分片
例2.12
让我们继续进行我们在例2.10中开始的数据库分布设计。我们已经根据PAY的分片决定了EMP关系的分片(例2.11)。现在让我们考虑ASG。假设有以下两个查询:
- 第一个查询找出在某些地方工作的工程师的名字。它在所有三个站点上运行,访问在本地项目工作的工程师信息的概率比其他地点项目的工程师信息的概率更高。
- 在管理员工记录的每个管理站点,用户希望访问这些员工所从事项目的职责,并了解他们将在这些项目上工作多长时间。
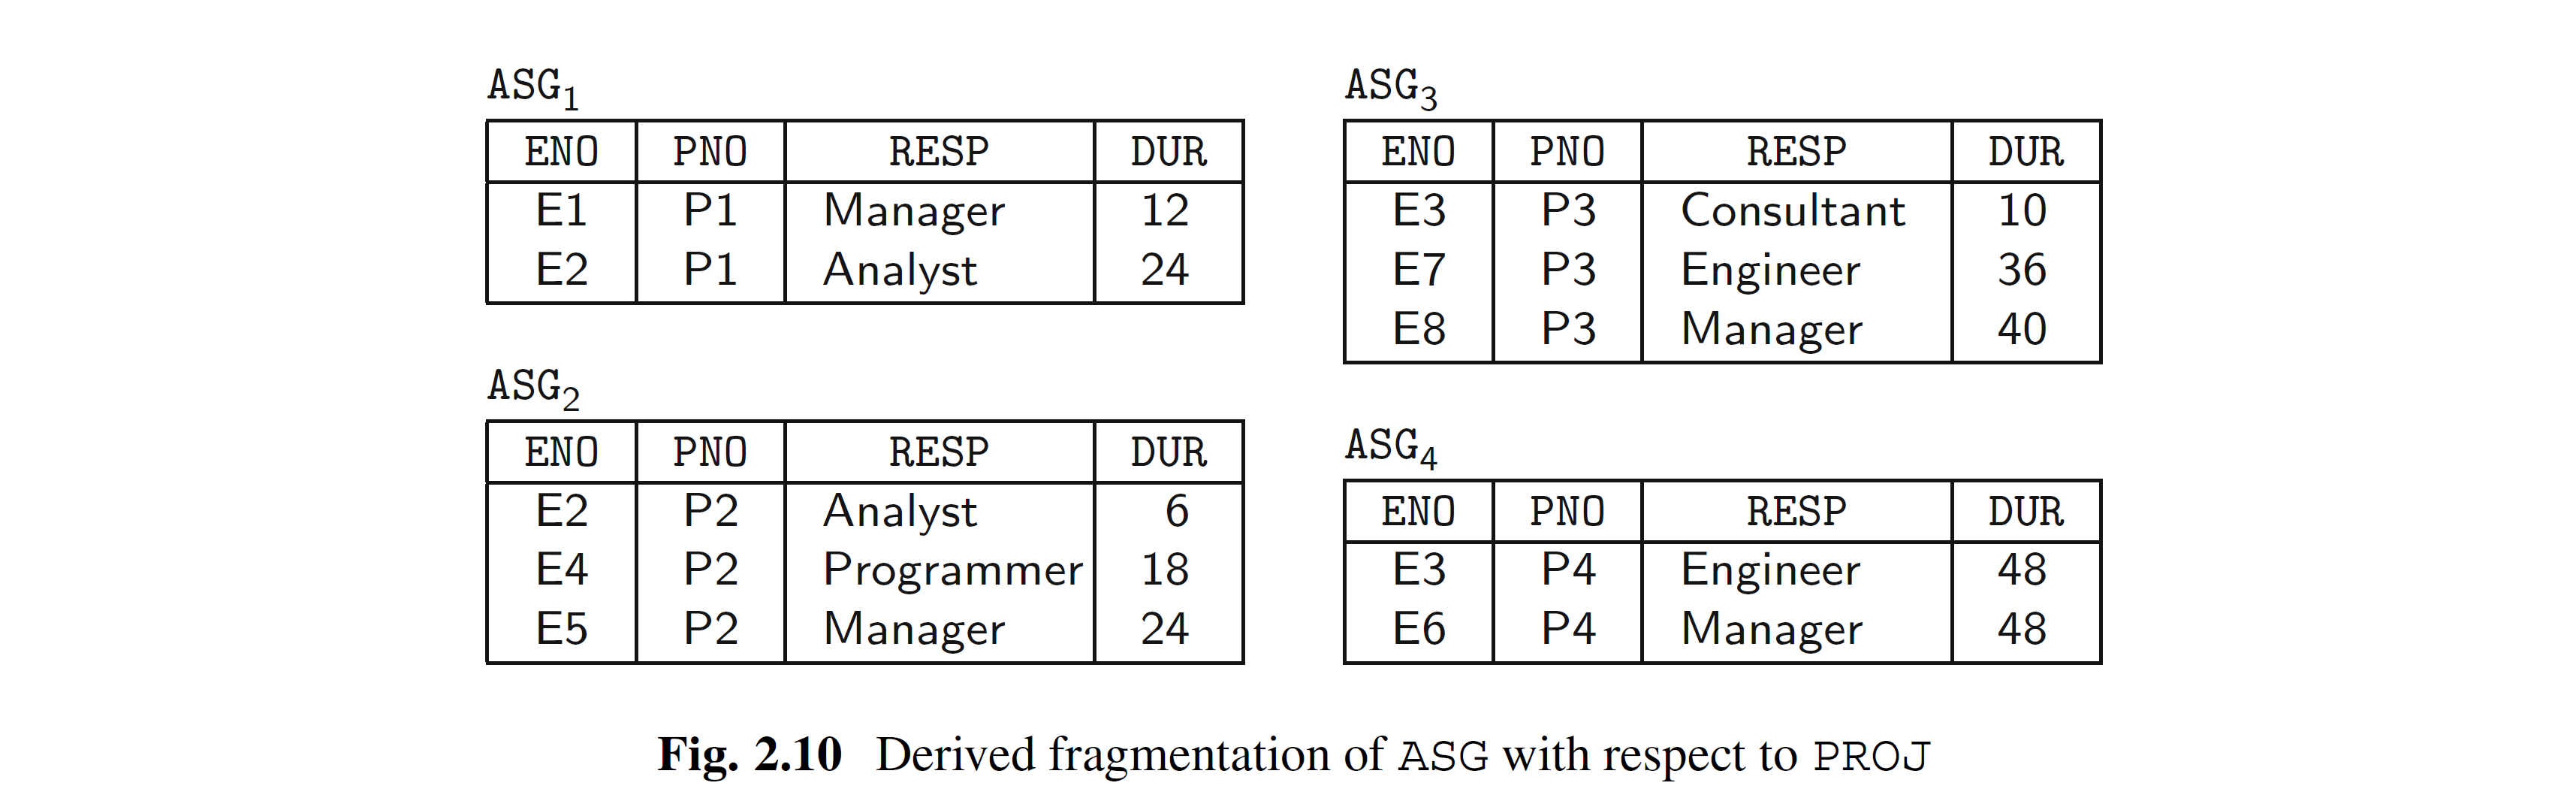
第一个查询导致ASG的分片是根据在例2.10中得到的PROJ的(非空)分片PROJ1、PROJ3、PROJ4和PROJ6来进行的:
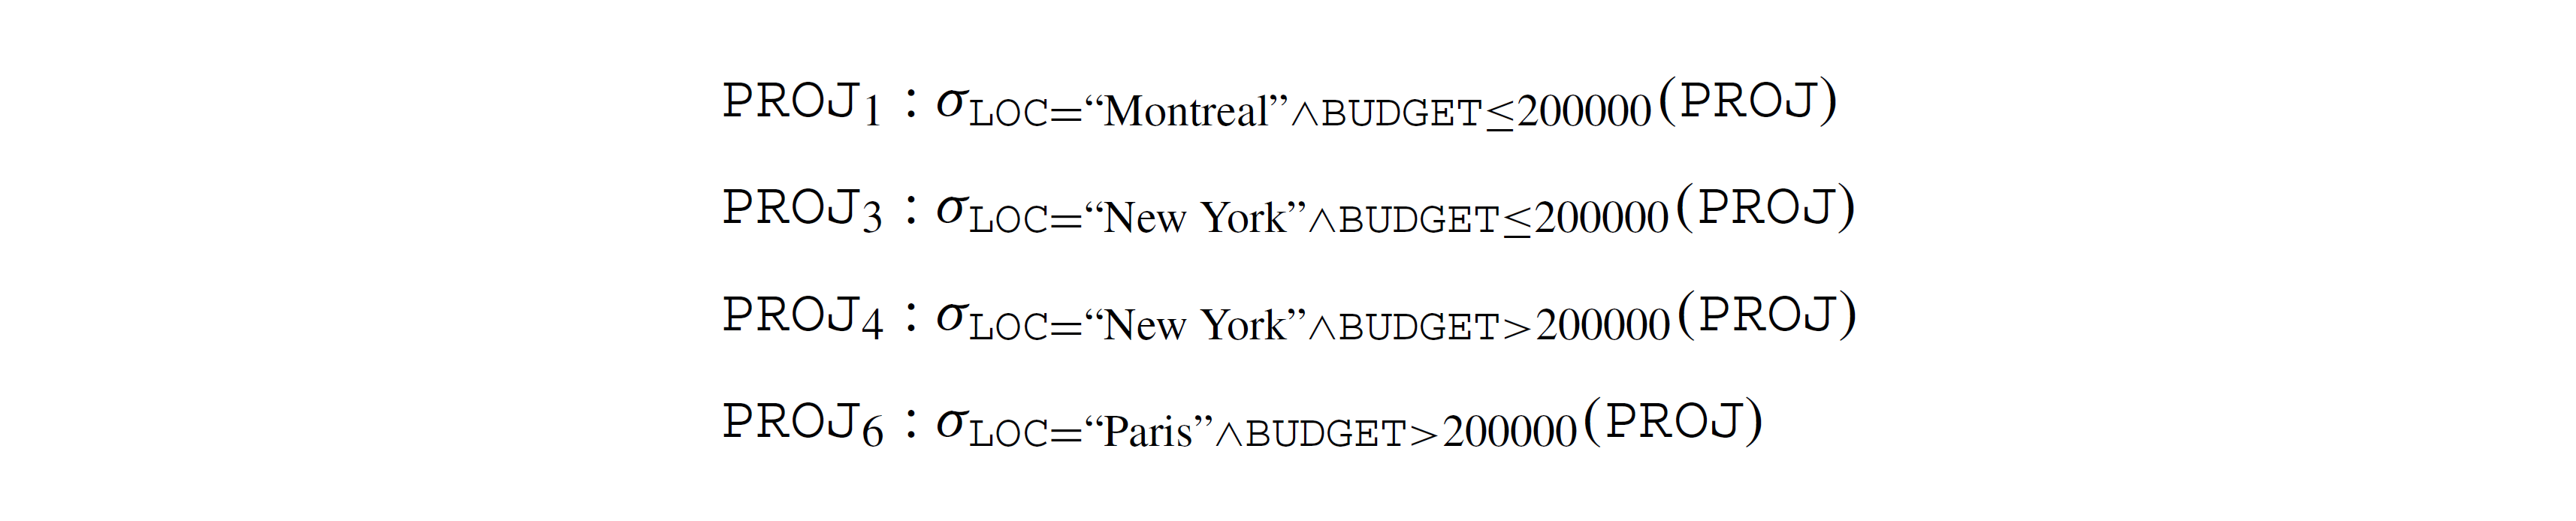
因此,根据{PROJ1, PROJ3, PROJ4, PROJ6}得出的ASG分片定义如下:
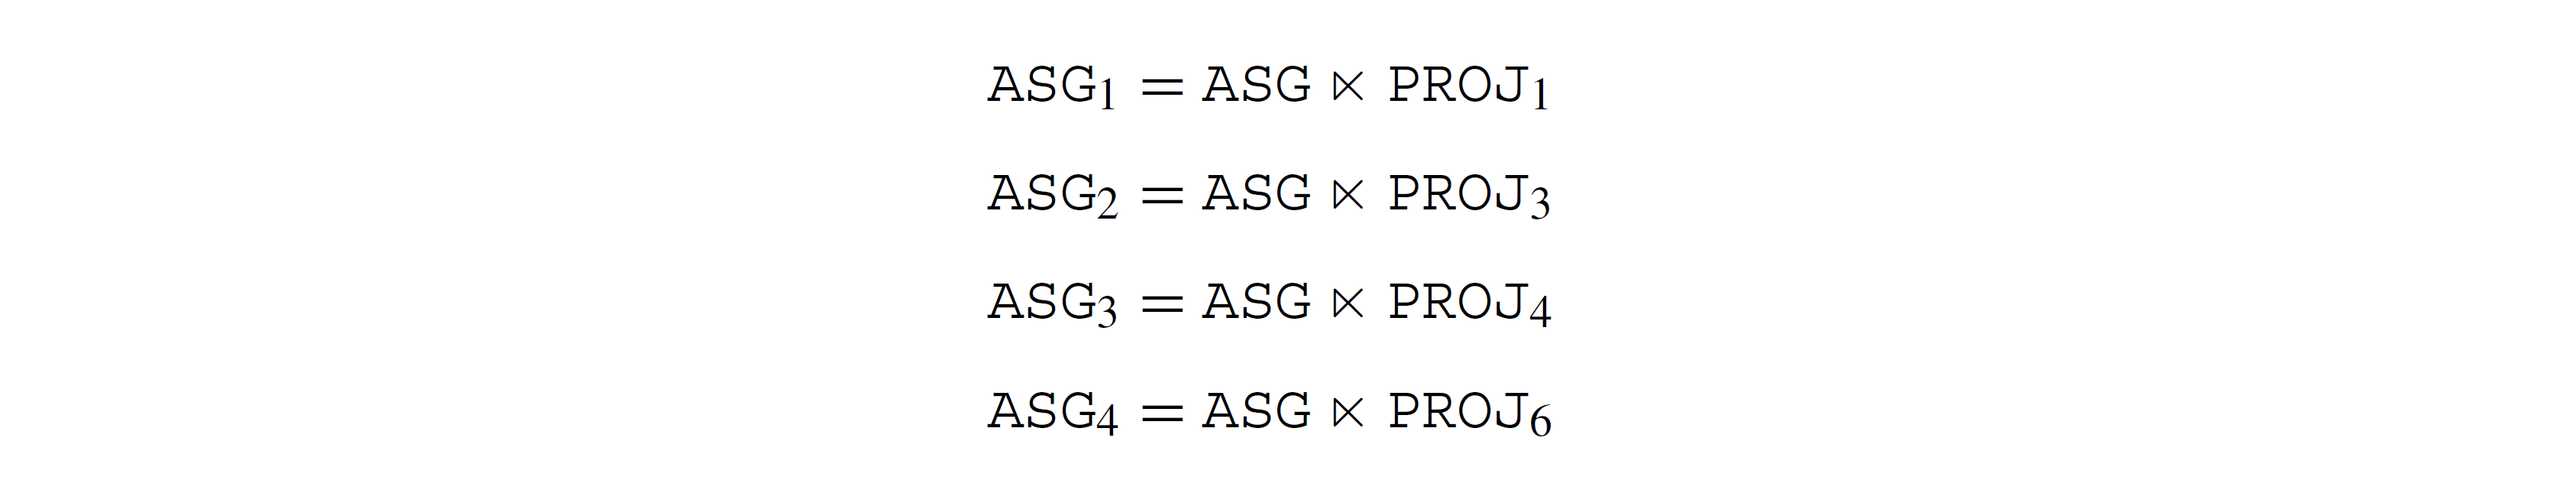
这些分片实例如图2.10所示,第二个查询可以用SQL表示为
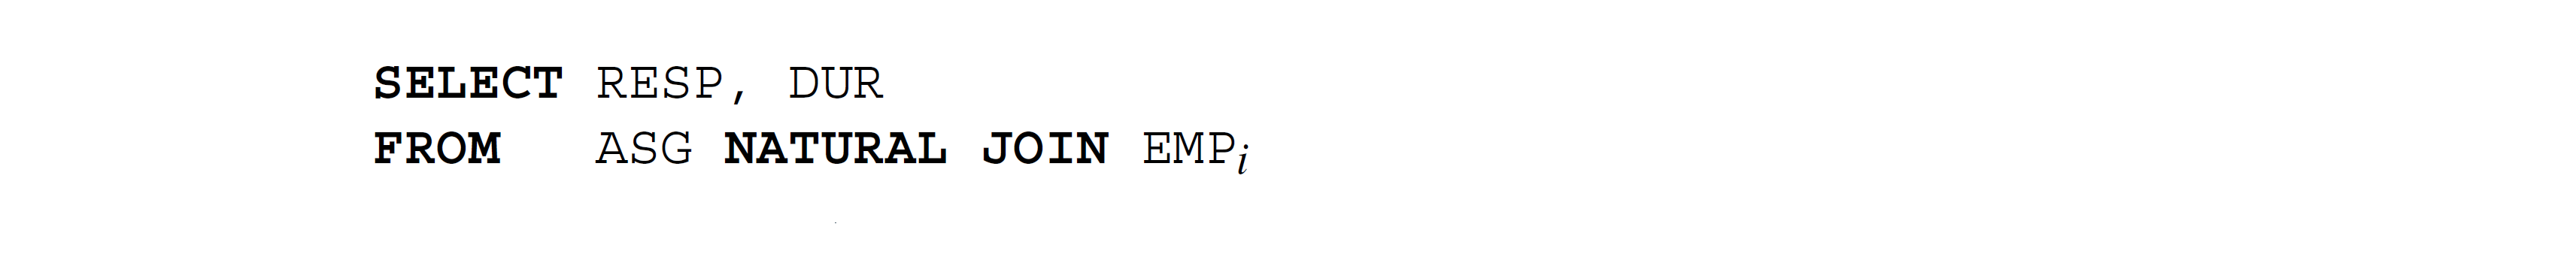
其中i = 1或i = 2,取决于发出查询的站点。根据EMP的分片得出的ASG分片定义如下,并在图2.11中描绘。
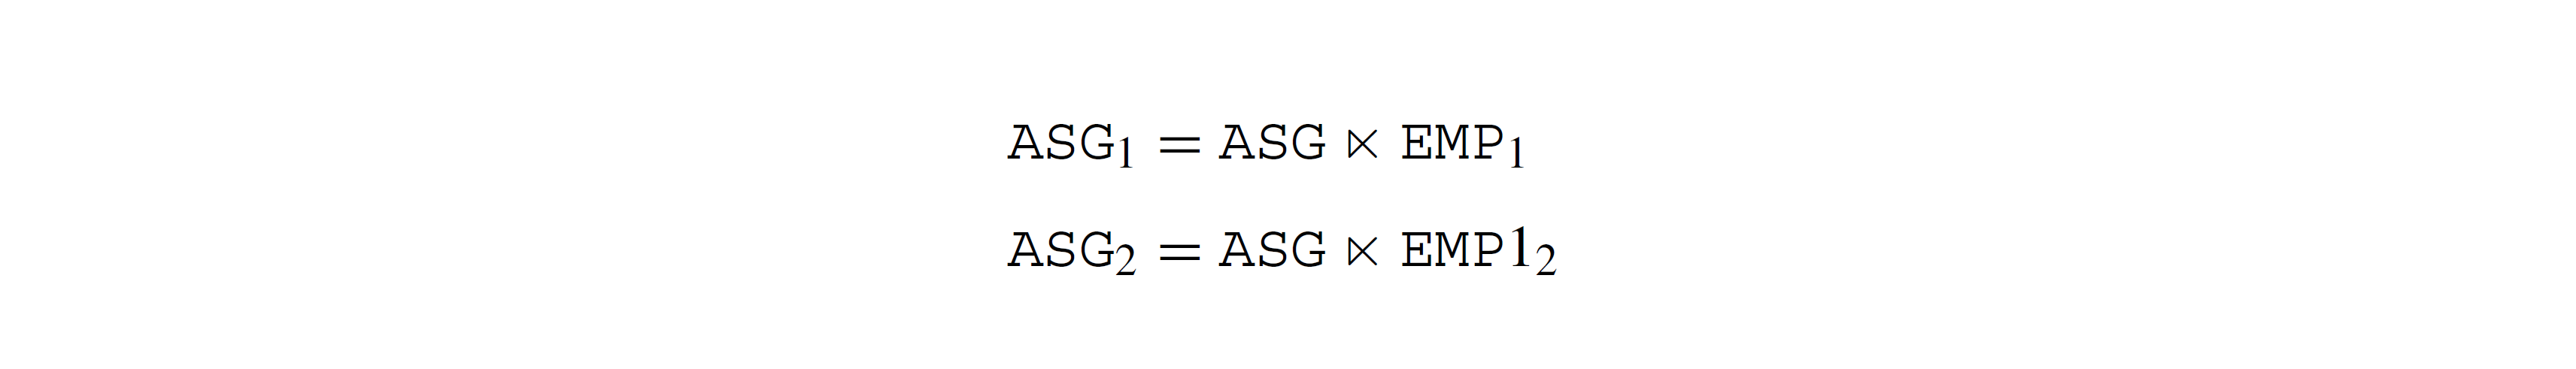
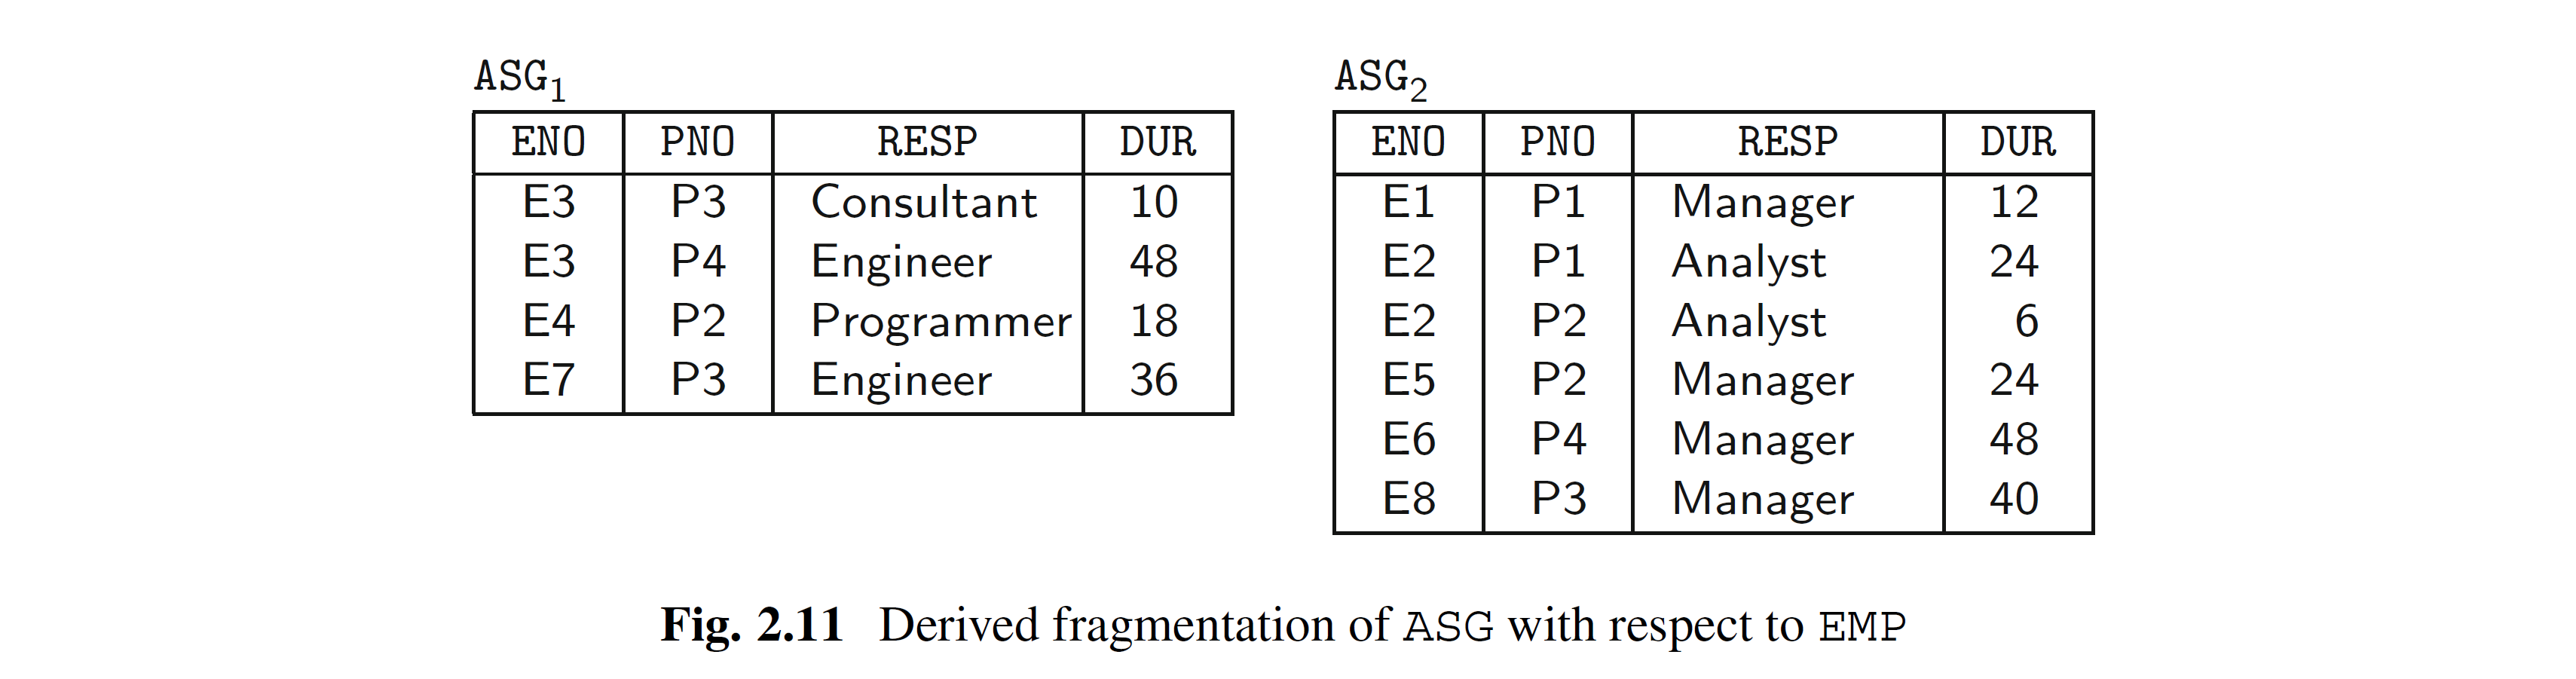
这个例子突出了两个观察结果:
- 派生分片可能会形成一个链条,其中一个关系的分片是由另一个关系的设计导致的,而它又引起了另一个关系的分片(例如,PAY → EMP → ASG 这样的链条)。
- 通常,对于一个关系来说,会有多个候选分片方案(例如,ASG关系)。最终选择哪种分片方案是一个决策问题,可能需要在分配阶段来解决。
2 垂直分片
例2.14
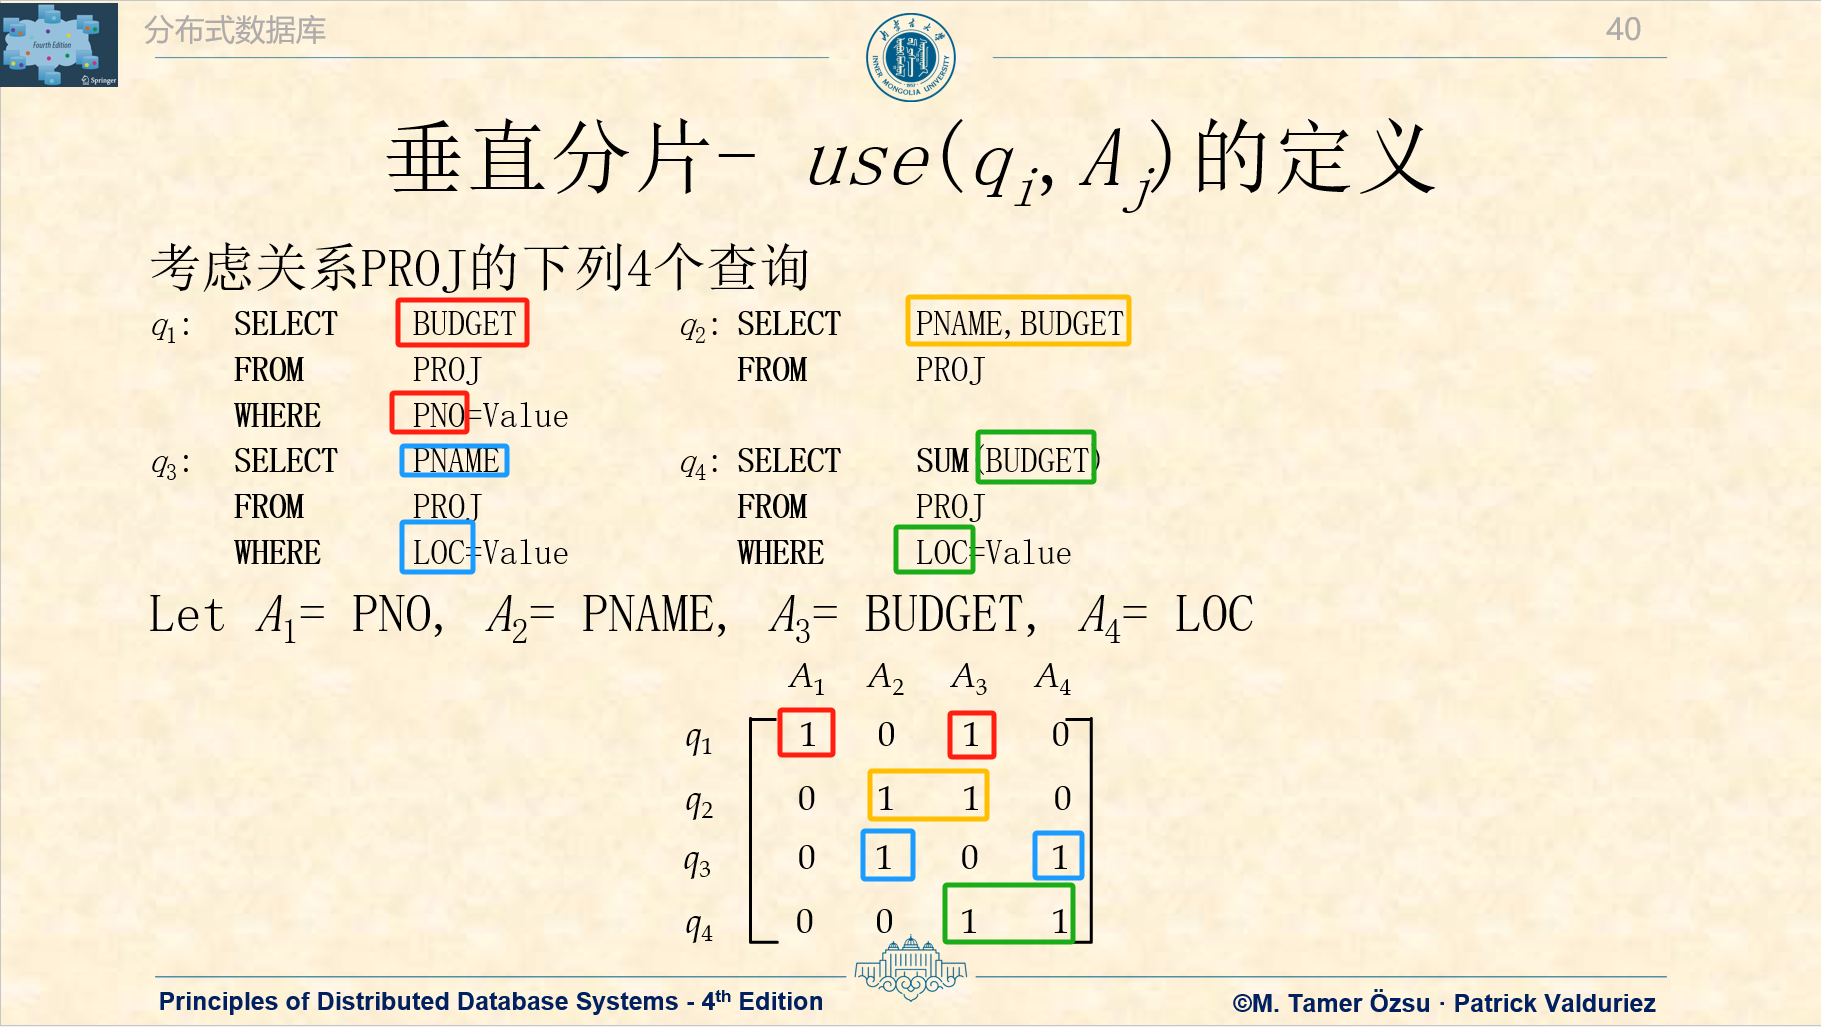
请考虑图2.2中的PROJ关系。假设以下查询被定义为在这个关系上运行。对于每个查询,我们还给出了相应的SQL表达式。
q1: 给定项目的识别号,查找该项目的预算。

q2: 查找所有项目的名称和预算。

q3: 查找位于给定城市的项目名称。

q4: 查找每个城市的项目总预算。

根据这四个查询,属性使用值可以用矩阵形式定义(如图2.12所示),其中条目(i, j)表示use(qi, Aj)。然而,属性使用值不足以成为属性分割和分片的基础,因为它们没有表示应用频率的权重。频率度量可以包含在属性亲和度度量aff(Ai, Aj)的定义中,这个度量根据查询访问属性的方式来衡量关系中两个属性之间的联系。
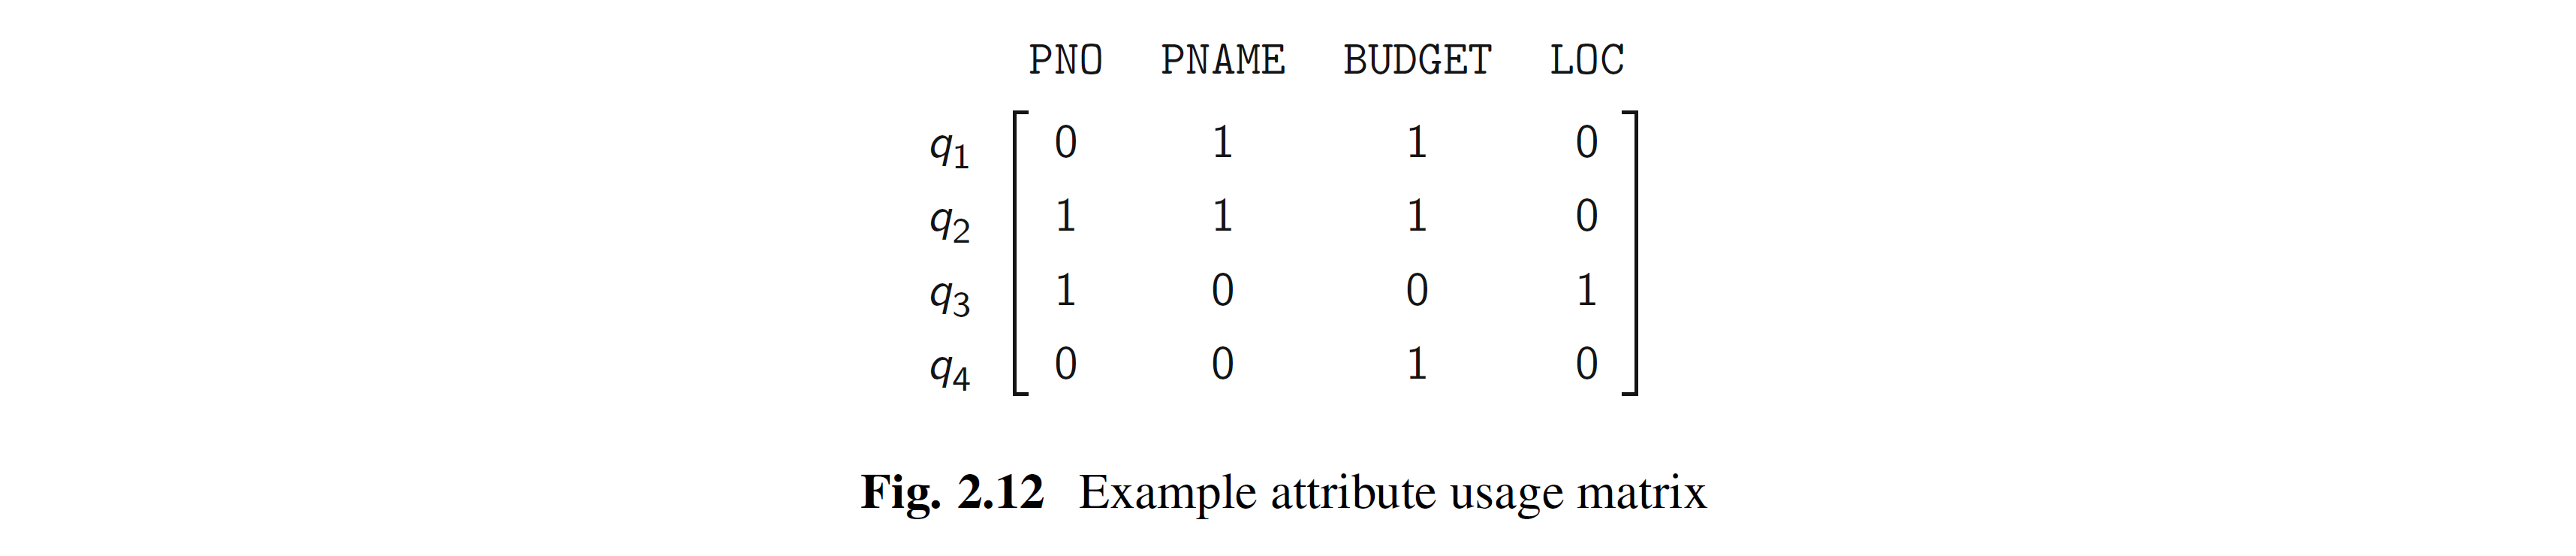
注:他这个矩阵有点问题,PPT上的应该是对的,矩阵是写法是:观察Select语句,把语句中Select和Where(如果有)后面的字段挑出来,编个号。之后如果查询中出现了这个字段,就在下面写一个1
对于关系R(A1, A2, …, An)中的两个属性Ai和Aj,考虑查询集合Q = {q1, q2, …, qq},它们之间的属性亲和度度量定义如下:
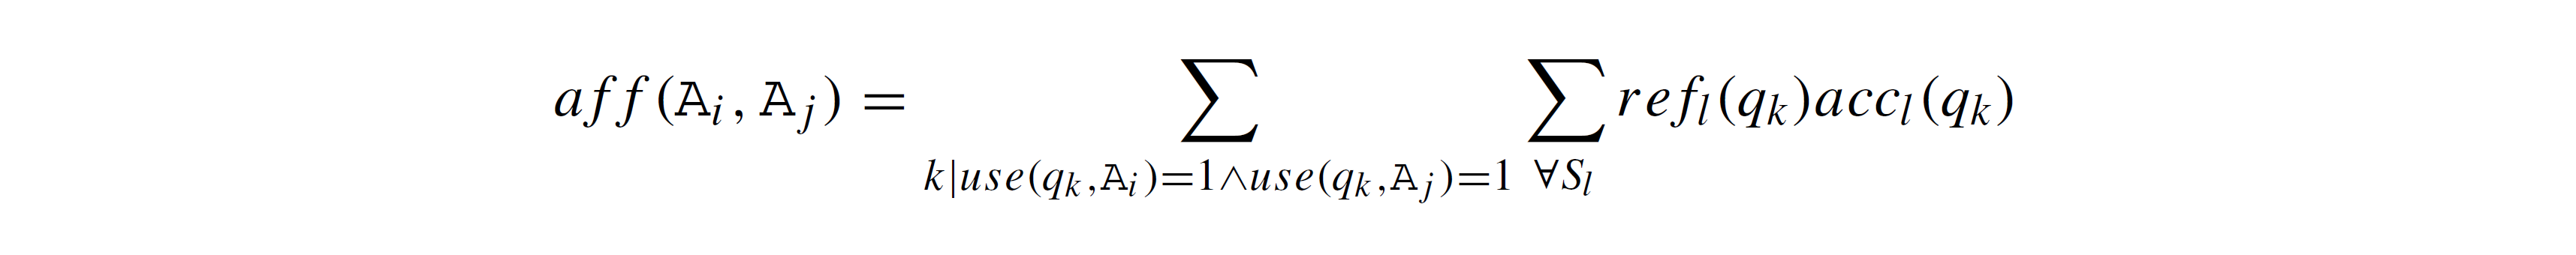
其中refl(qk)是应用qk在站点Sl上每次执行时对属性(Ai, Aj)的访问次数,accl(qk)是之前定义的应用访问频率度量,并经过修改以包含在不同站点的频率。这个计算的结果是一个n×n矩阵,其中每个元素都是上面定义的度量之一。这个矩阵被称为属性亲和度矩阵(AA)。
例2.15
让我们继续研究我们在例2.14中检查的情况。为了简化,我们假设对于所有的qk和Sl,refl(qk) = 1。如果应用频率是
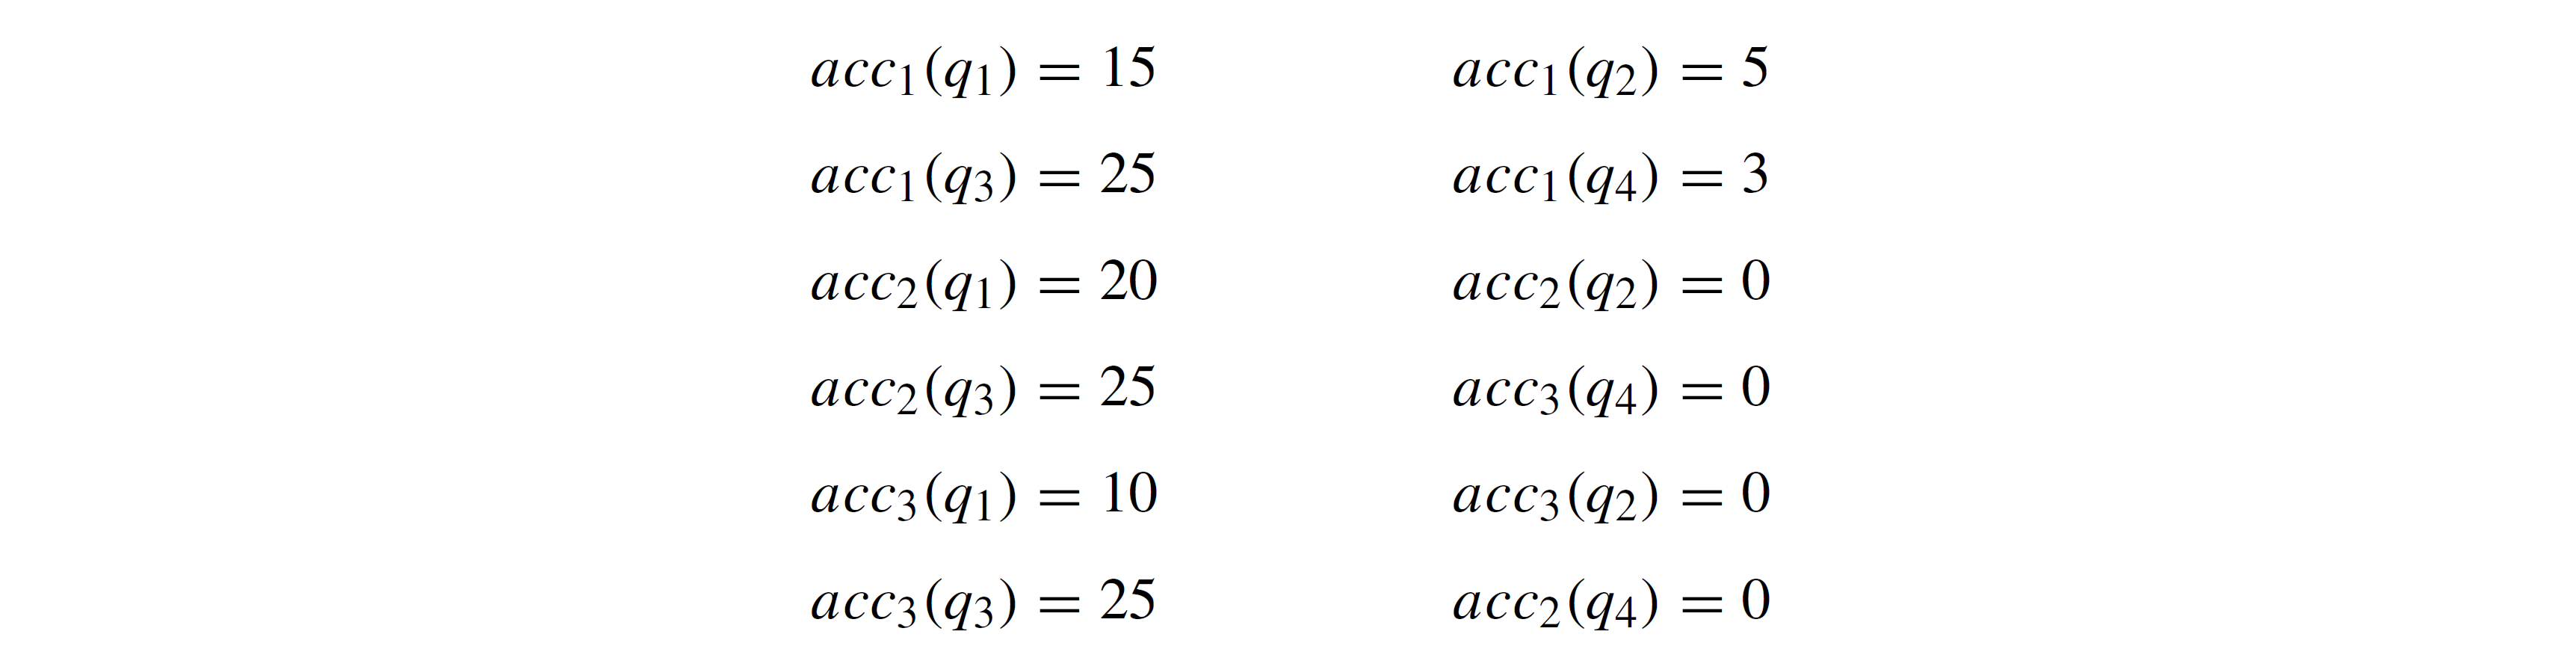
那么属性PNO和BUDGET之间的亲和度度量可以计算为
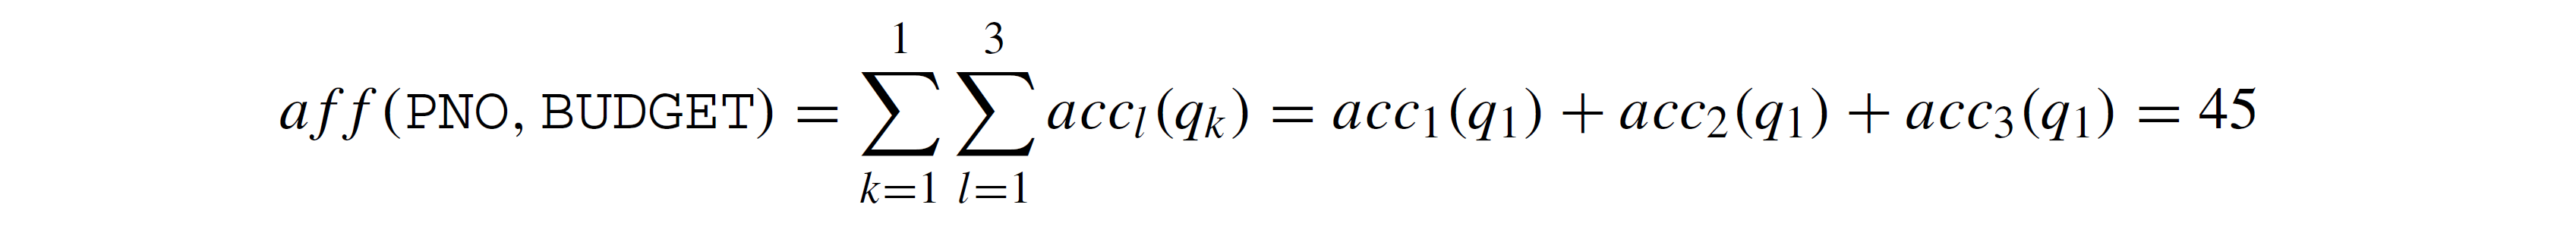
因为只有q1这个应用同时访问了这两个属性。完整的属性亲和度矩阵如图2.13所示。注意,对角线上的值并未计算,因为它们没有意义。
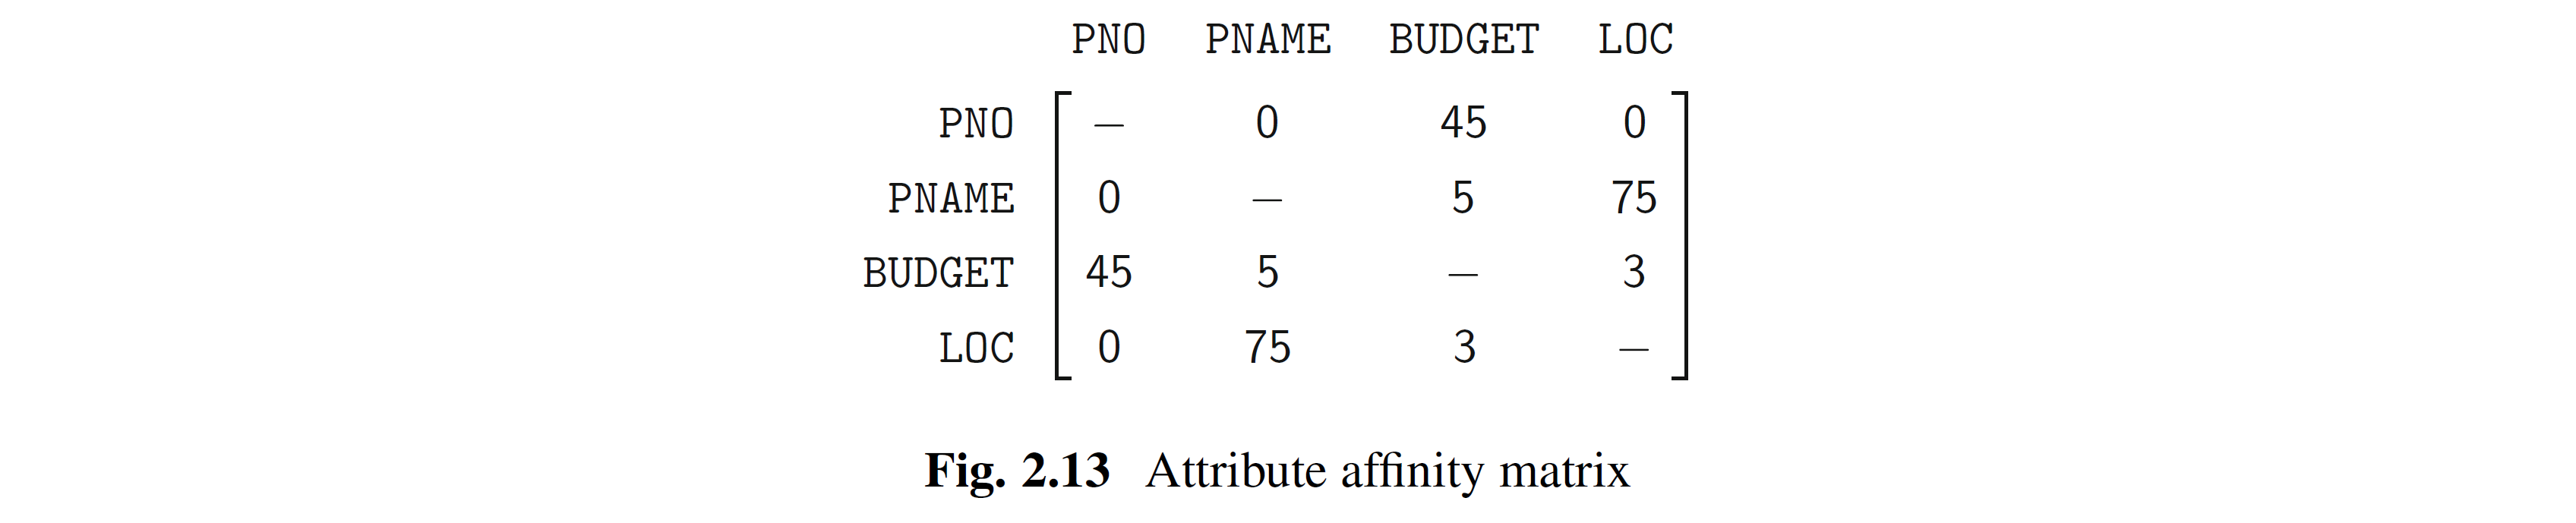
属性亲和度矩阵将在本章的余下部分用于指导分片工作。这个过程首先将彼此具有高亲和度的属性聚集在一起,然后相应地分割关系。
例2.16
让我们考虑图2.13中给出的AA矩阵,并研究将属性LOC在属性PNO和PNAME之间移动的贡献,这由以下公式给出:
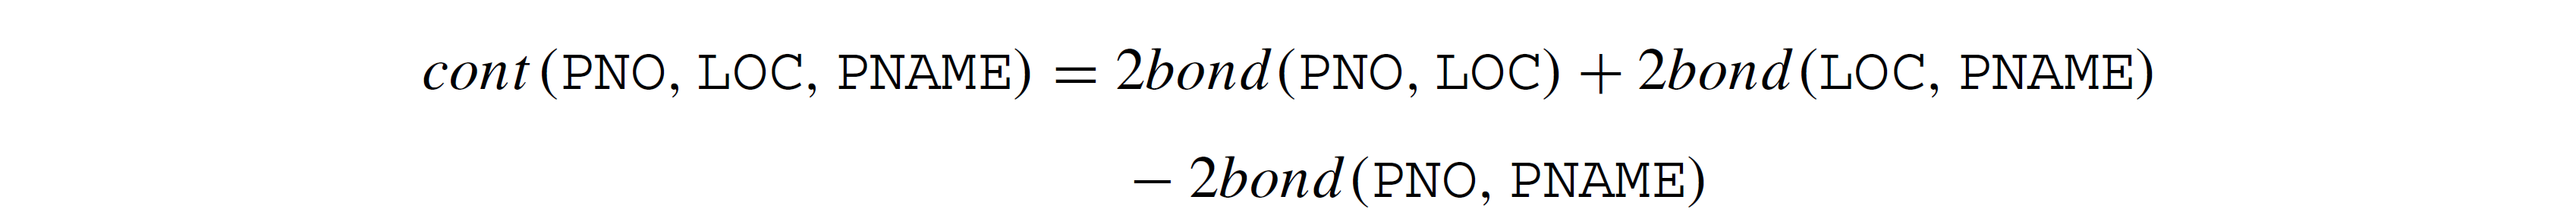
计算每一项,我们得到
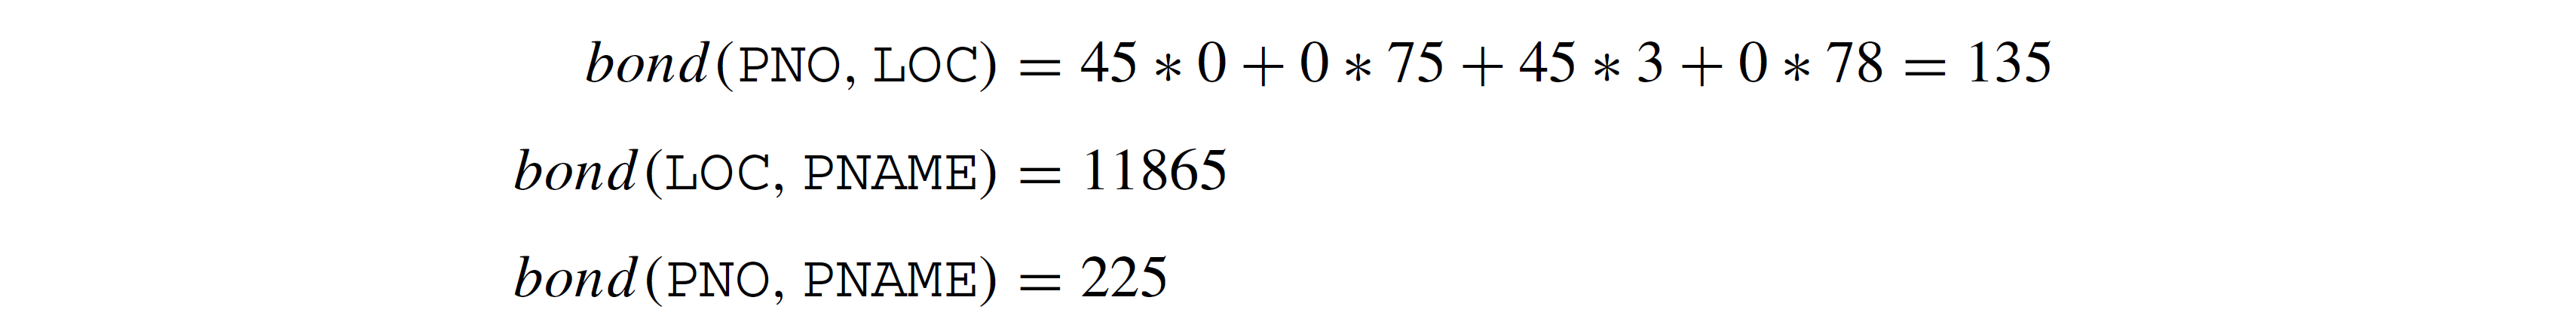
因此
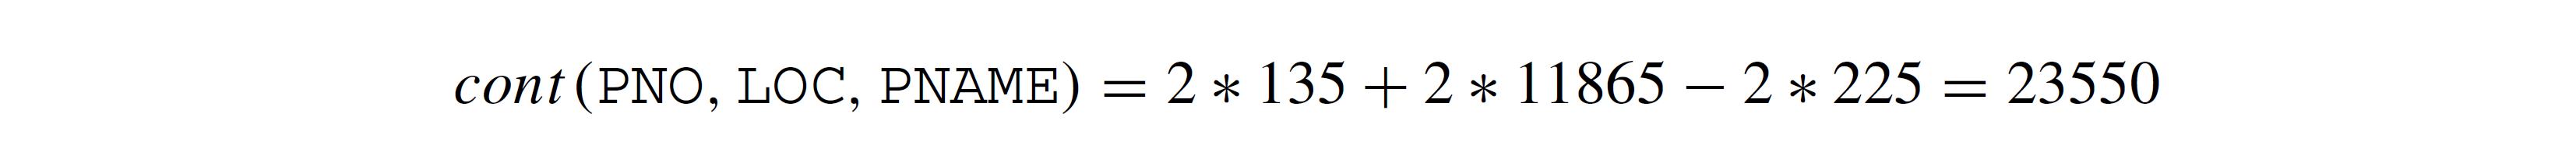
算法和我们到目前为止的讨论都集中在属性亲和度矩阵的列上。可以重新设计算法以对行进行操作。由于AA矩阵是对称的,这两种方法都会产生相同的结果。
请注意,算法2.3在初始化步骤中将第二列放在第一列旁边。这显然是有效的,因为它们之间的联系与它们彼此的相对位置无关。在端点计算cont需要小心。如果考虑将属性Ai放置在最左侧属性的左边,需要计算的一个联系方程是不存在的左元素和Ak之间的联系[即bond(A0, Ak)]。因此,我们需要参考全局亲和度度量AM定义中施加的条件,其中CA(0, k) = 0。类似的论点也适用于放置在最右侧属性的右边。
例2.17
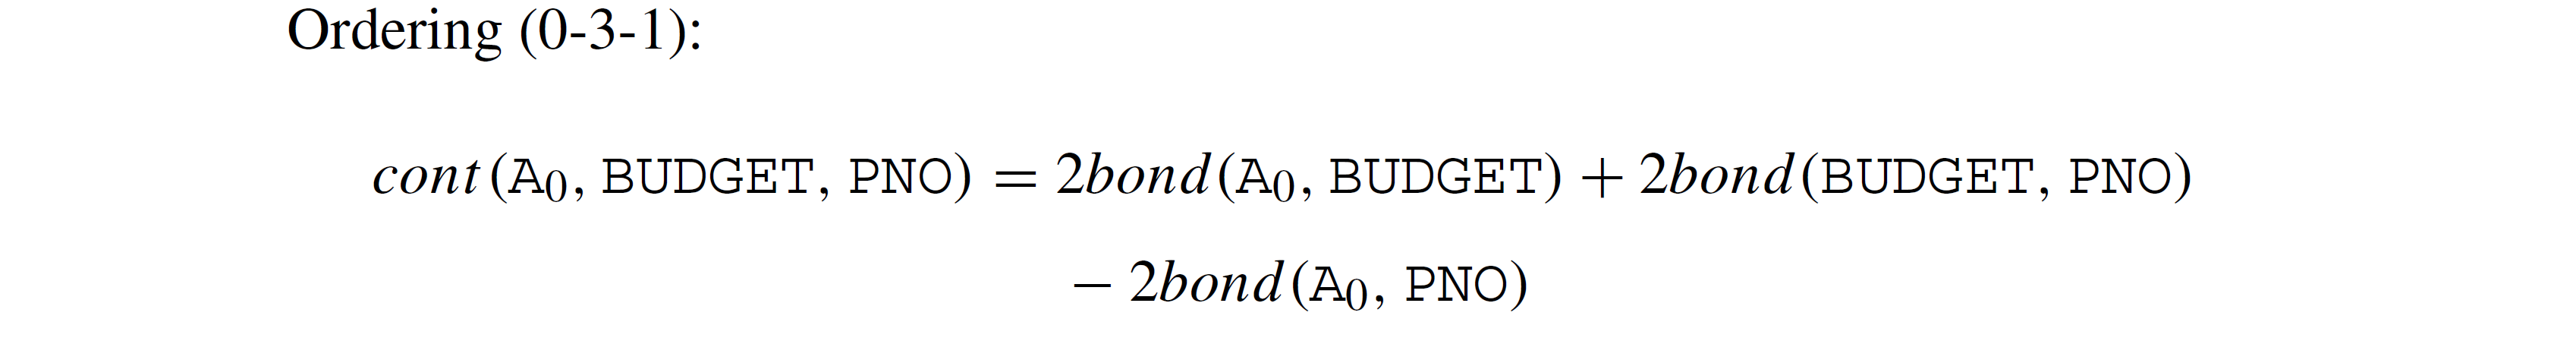
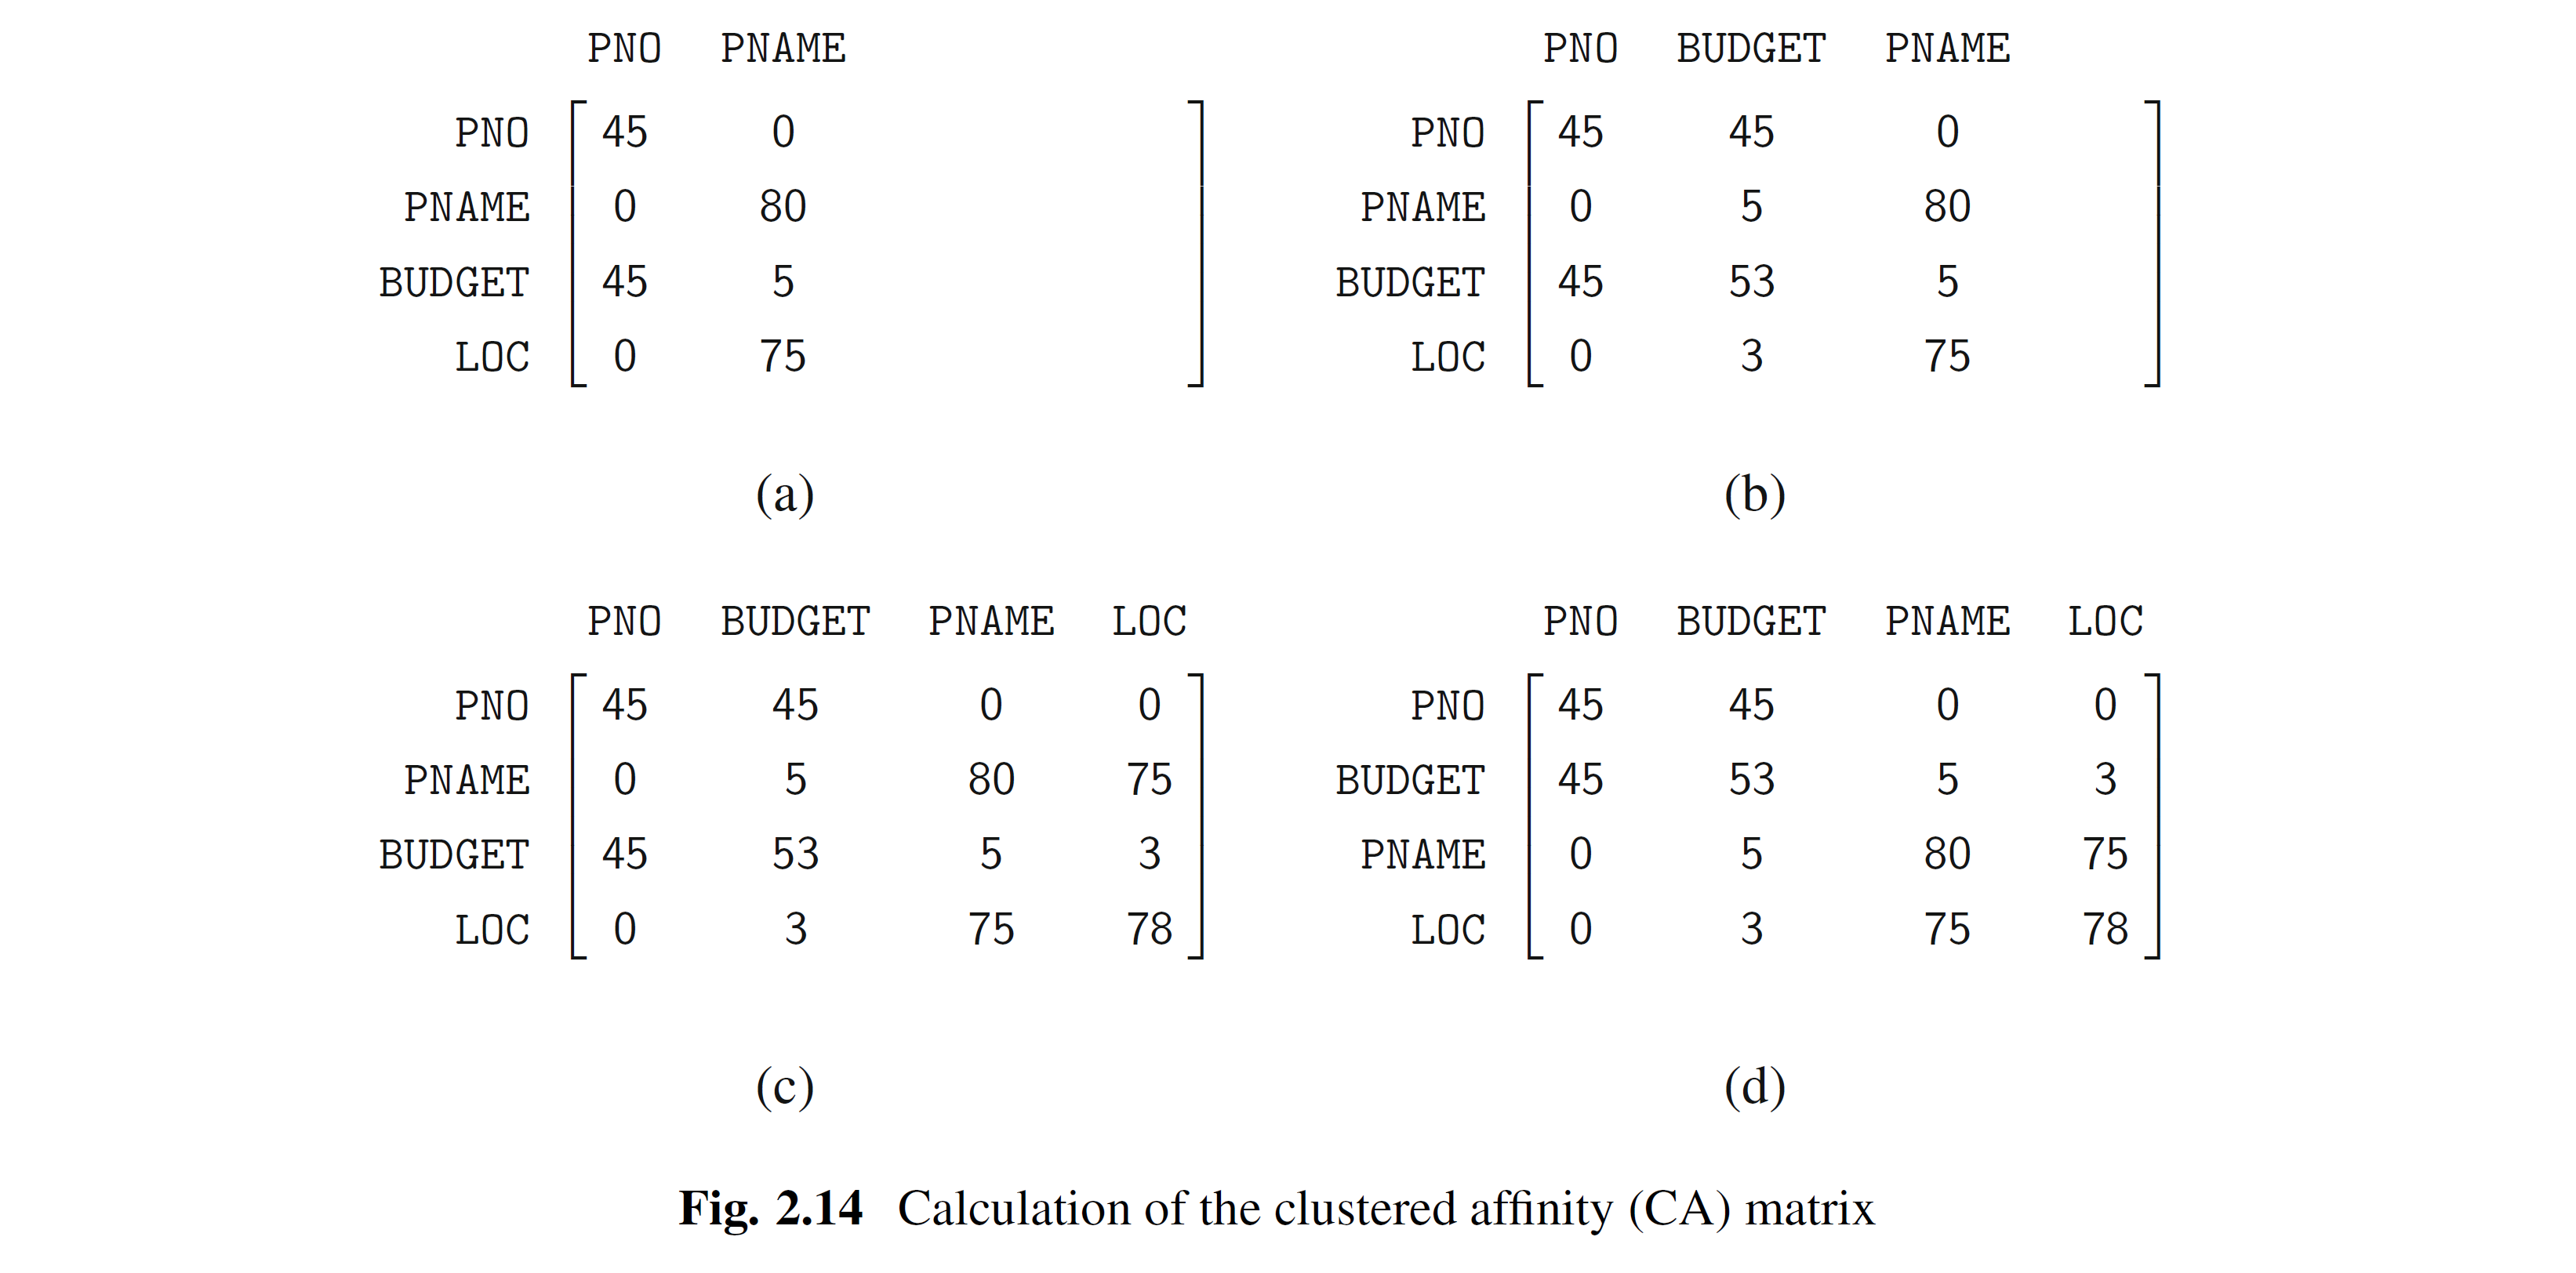
我们考虑PROJ关系属性的聚类,并使用图2.13中的属性亲和度矩阵AA。根据初始化步骤,我们将AA矩阵的第1列和第2列复制到CA矩阵中(图2.14a),并从第3列(即属性BUDGET)开始。第3列可以放置在三个可选位置:
- 放在第1列的左边,得到顺序(3-1-2)
- 放在第1列和第2列之间,得到顺序(1-3-2)
- 放在第2列的右边,得到顺序(1-2-3)
注意,要计算最后一种排序的贡献,我们需要计算cont(PNAME, BUDGET, LOC)而不是cont(PNO, PNAME, BUDGET)。然而,属性LOC还没有被放入CA矩阵中(图2.14b),因此需要如上所述的特殊计算。让我们计算每种选择对全局亲和度度量的贡献。
注:
要把加入的列放在中间来计算cont(Ai,Ak,Aj),加入的是A3,所以k=3。而i是放在k左边的列,j是放在k右边的列,第一种情况下,A3在第一列的左边,所以A3左边没有列,所以i=0 |
我们知道
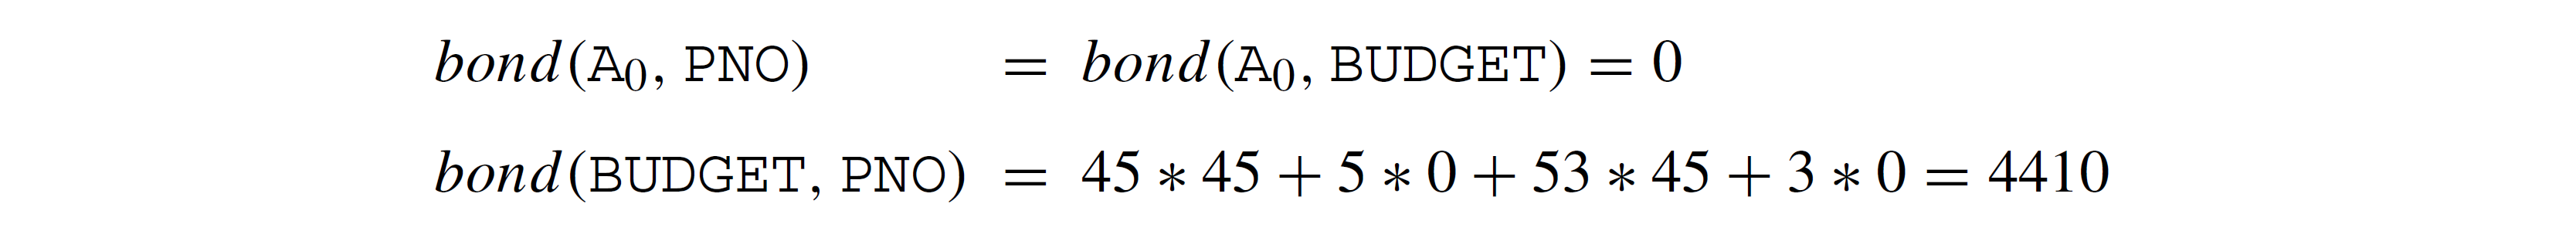
因此
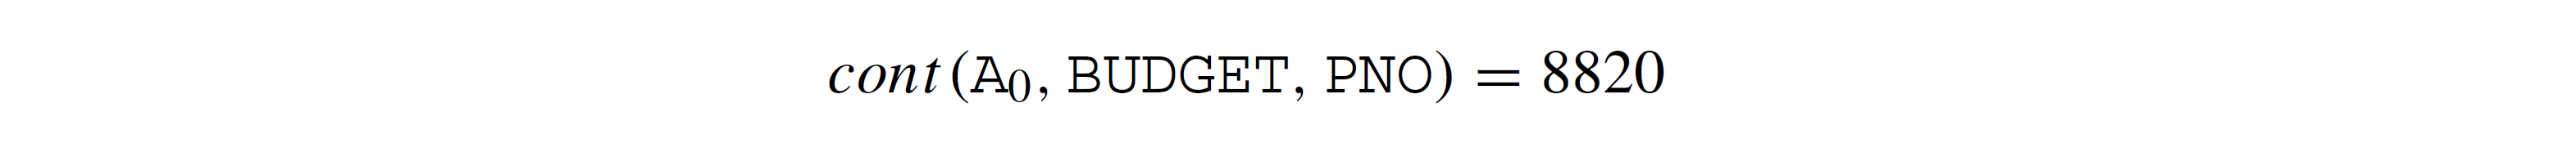
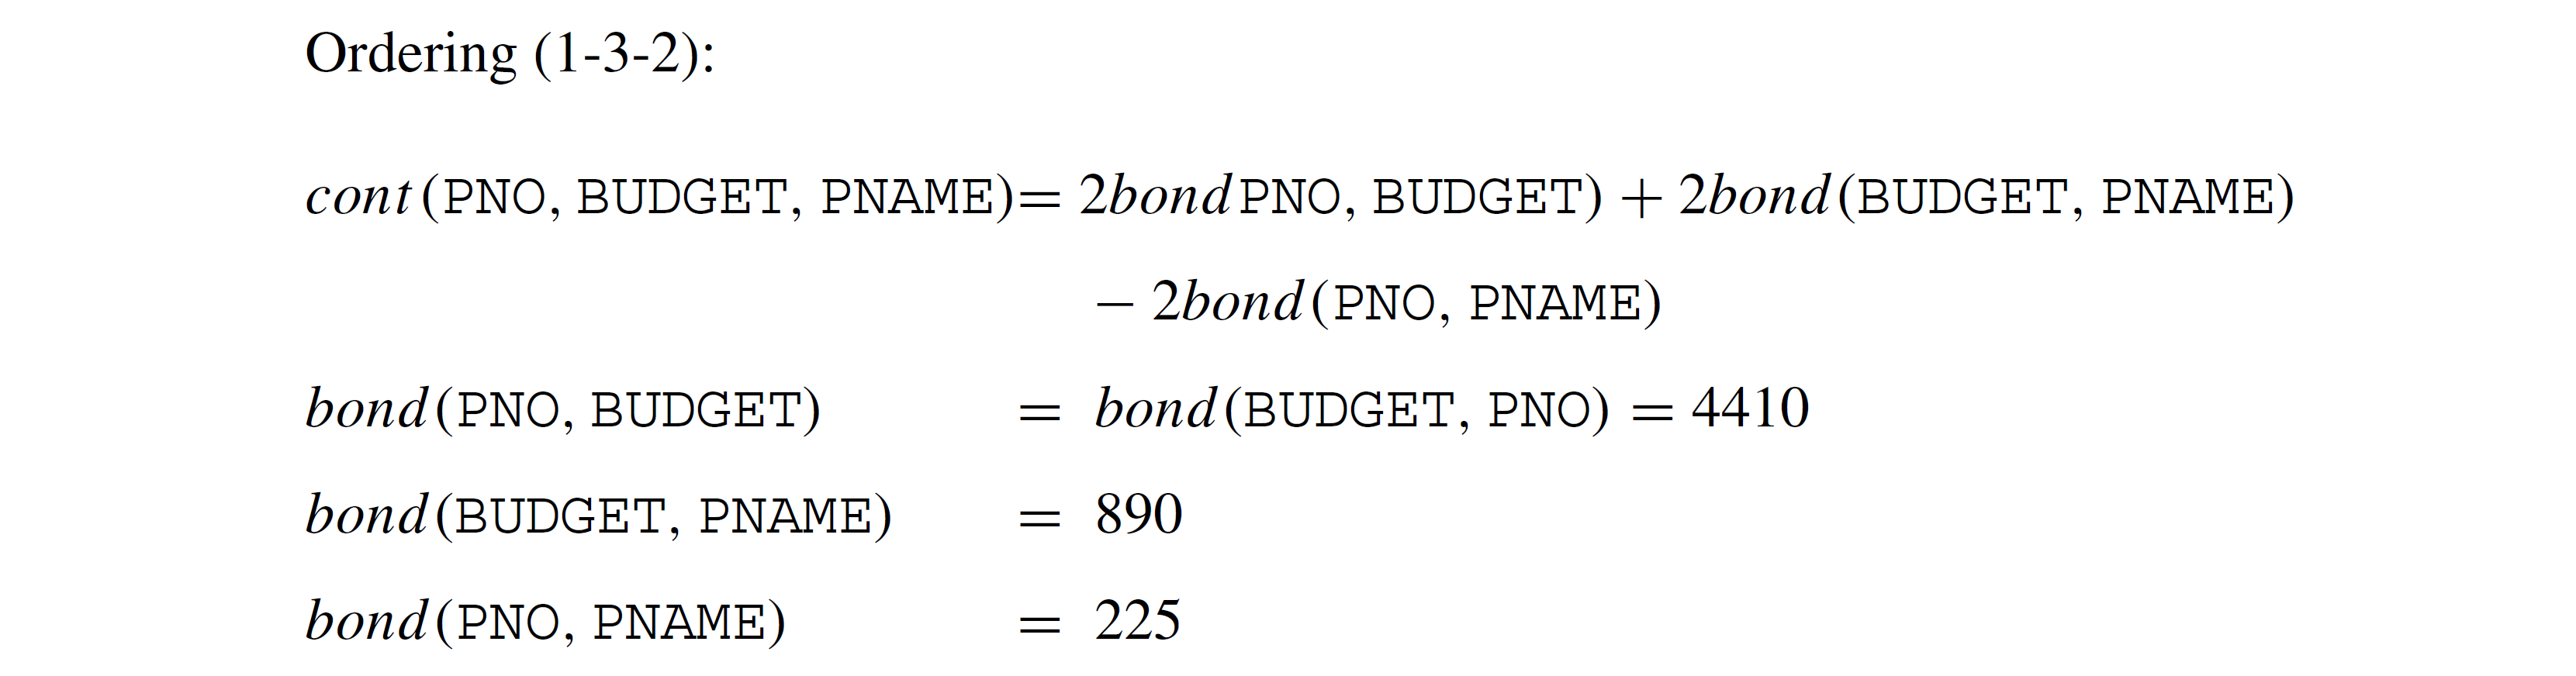
因此
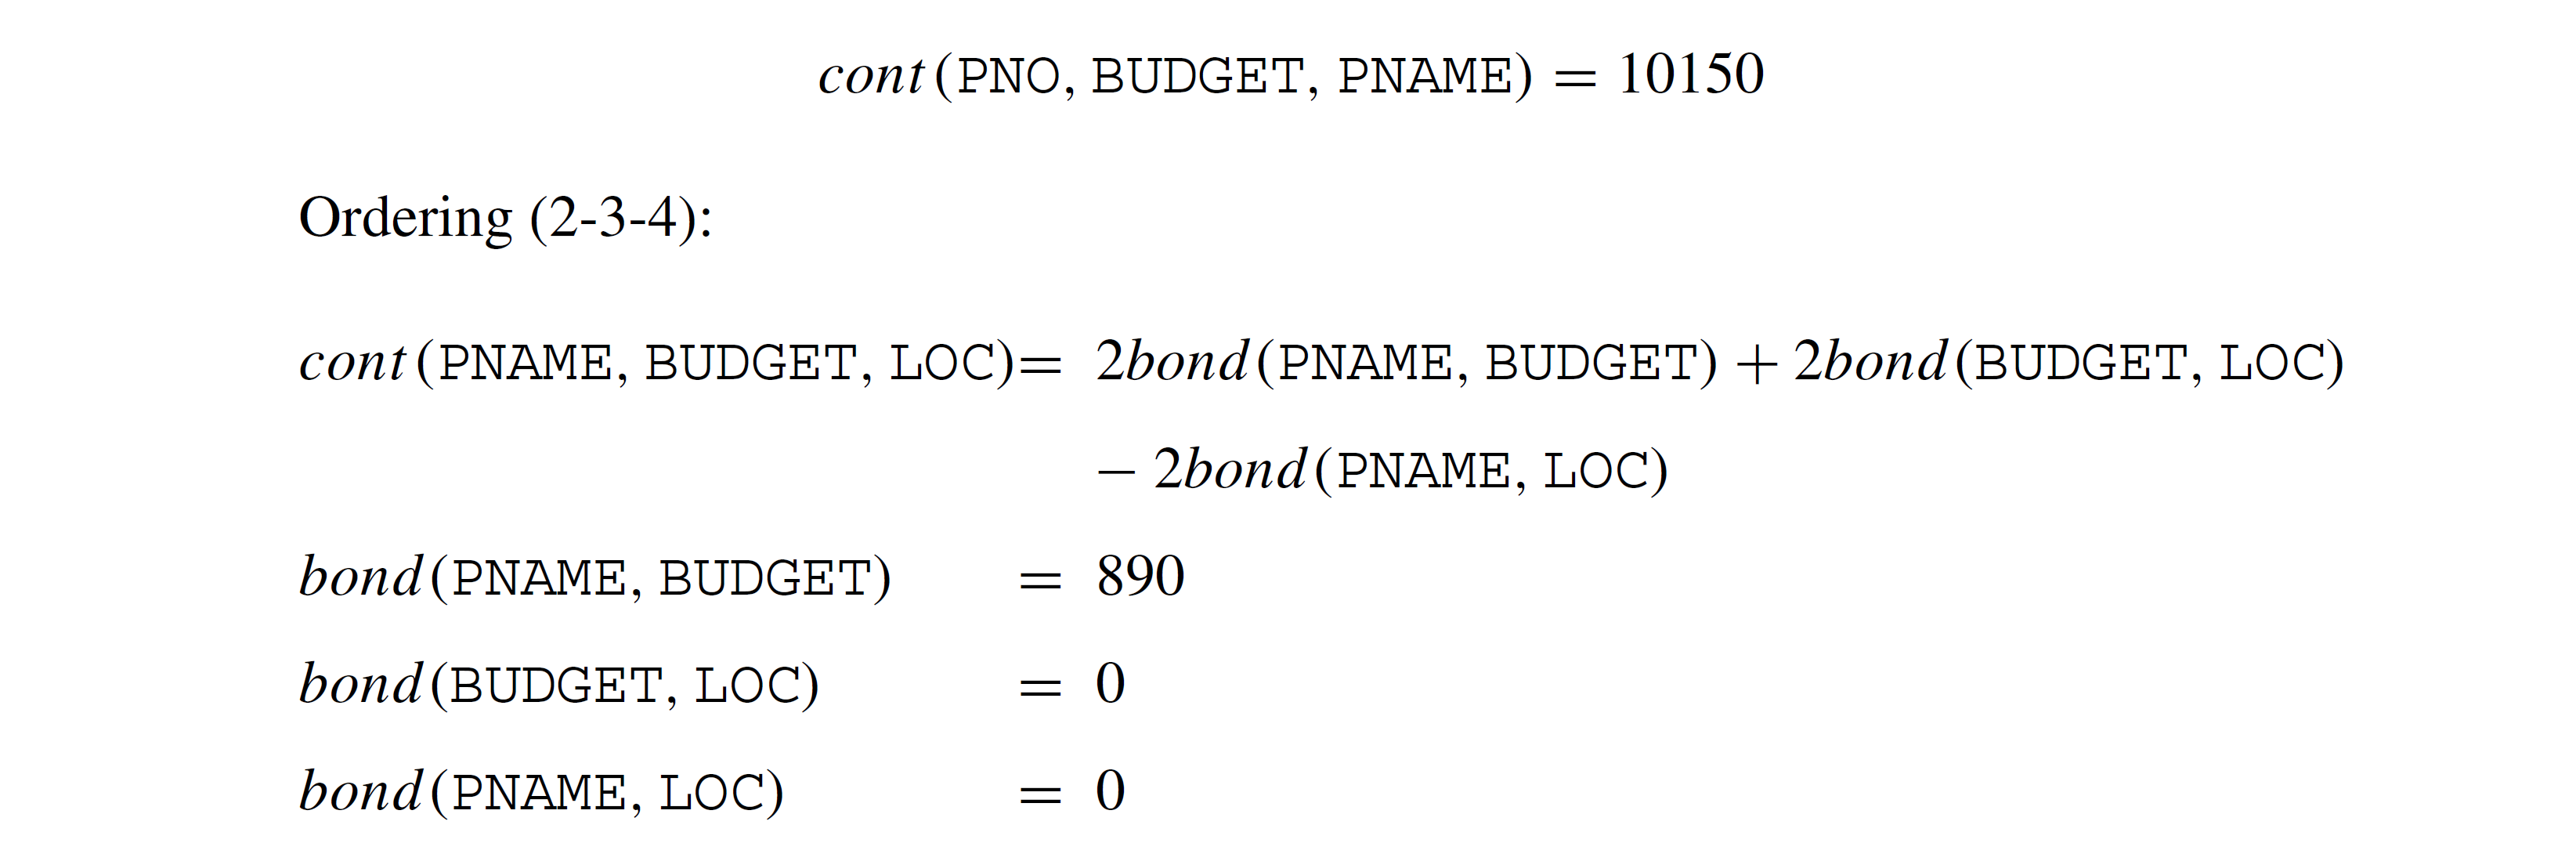
因此

由于排序(1-3-2)的贡献最大,我们选择将BUDGET放在PNO的右边(图2.14b)。对LOC进行类似的计算表明,它应该被放置在PNAME的右边(图2.14c)。最后,行按照与列相同的顺序排列,结果如图2.14d所示。
在图2.14d中,我们看到形成了两个集群:一个在左上角,包含较小的亲和度值;另一个在右下角,包含较大的亲和度值。这种聚类表明了PROJ关系的属性应该如何分割。然而,一般情况下,这种分割的边界可能不会如此明确。当CA矩阵较大时,通常会形成两个以上的集群,并且会有多个候选分割方案。因此,需要更系统地处理这个问题。
3 视图
习题3.1
用类似SQL的语法定义工程数据库的视图V(ENO, ENAME, PNO, RESP),其中持续时间是24。视图V是否可更新?
假设关系EMP和ASG基于访问频率进行了水平分片,如下所示:
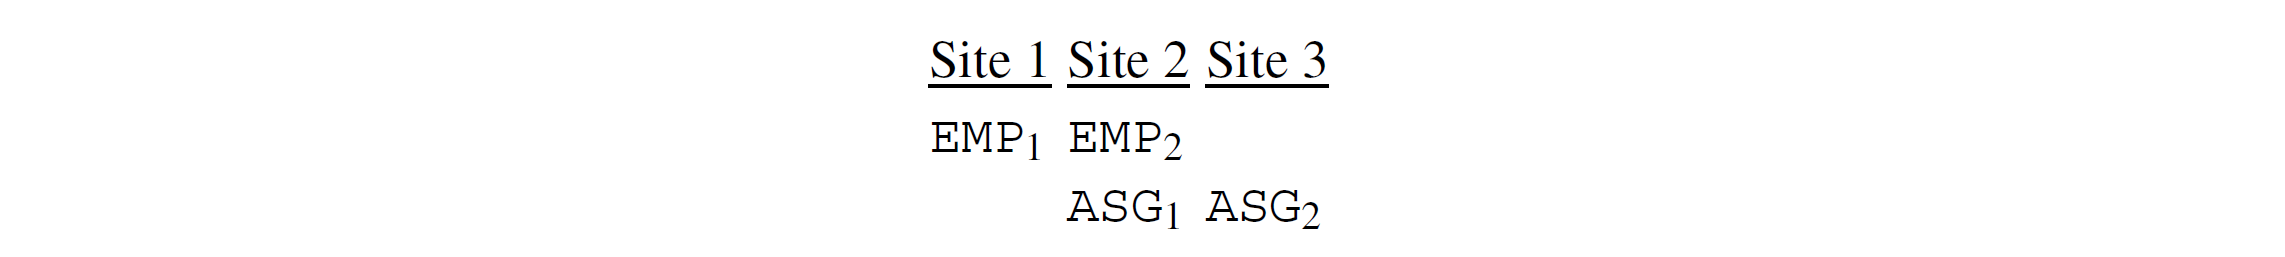
当
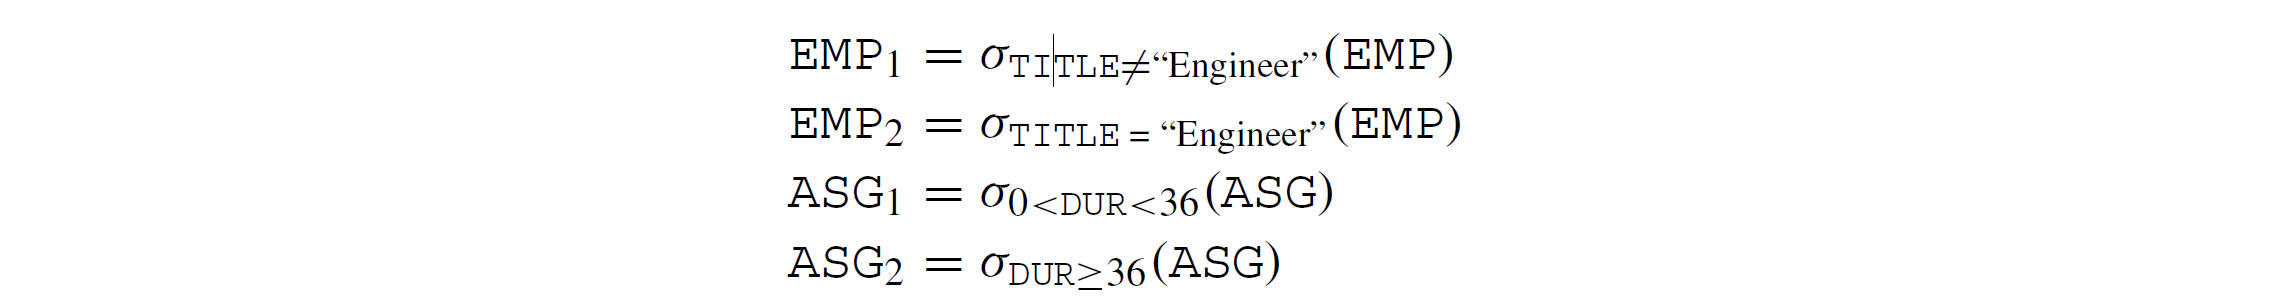
视图V的定义应该存储在哪个(些)站点上而不被完全复制,以提高引用的局部性?
前人答案
可更新视图可以将更新操作无歧义地传递到基础关系表上,传递的意思就是把视图里的条件用AND连接到更新操作里在基础关系表能执行(没语法错误?猜测应该是这个意思)
CREATE VIEW V(ENO,ENAME,PNO,RESP) |
网上Chegg找的答案
① 让我们根据提供的信息,用类似SQL的语法定义视图V:
CREATE VIEW V AS |
这个视图从EMP和ASG表中选择员工编号(ENO)、员工姓名(ENAME)、项目编号(PNO)和职责(RESP),其中员工编号匹配且持续时间为24。
② 现在,让我们讨论一下视图的可更新性。在SQL中,视图的可更新性取决于某些条件。通常,如果一个视图满足以下标准,它就是可更新的:
- 它在SELECT语句的FROM子句中只包含一个表。
- 它不包含任何聚合函数。
- 它不包含任何DISTINCT、GROUP BY、HAVING或ORDER BY子句。
因此,这个涉及多个表的视图在SQL中可能无法直接更新。为了实现可更新性,可能需要使用INSTEAD OF触发器。为了获得最佳性能和提高引用局部性,应该将视图定义存储在对这些表(EMP和ASG)访问最频繁的站点上,因为这些关系在多个站点上进行了水平分片。这样可以在查询过程中最大限度地减少跨站点通信。
③ 关于存储视图定义以增加引用局部性,这取决于涉及的表的访问模式和频率。考虑到关系在三个站点(站点1、站点2和站点3)上进行了水平分片,您可能想要将视图定义存储在对所涉及的表(EMP和ASG)访问最频繁的站点上。这将减少查询视图时跨站点通信的需求,从而提高整体性能
4 完整性描述
习题3.9
使用本章的完整性约束规范语言,表达一个完整性约束,声明项目所花费的时间不能超过48个月
答案
# 前人写的 |
语法:
# 预编译约束 |
5 归约
习题4.3
假设关系PROJ如习题4.1中那样被分割,此外,关系ASG被间接分割为
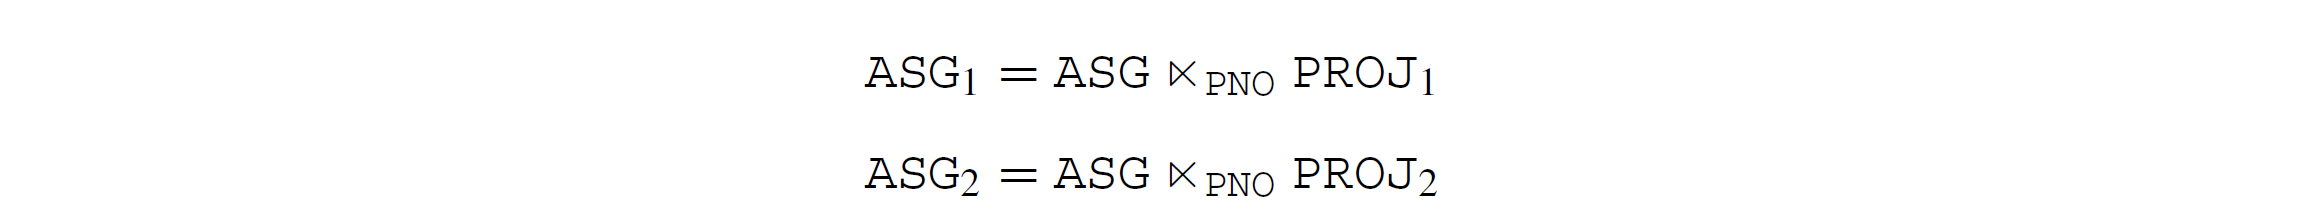
且关系EMP在垂直方向上被分割为

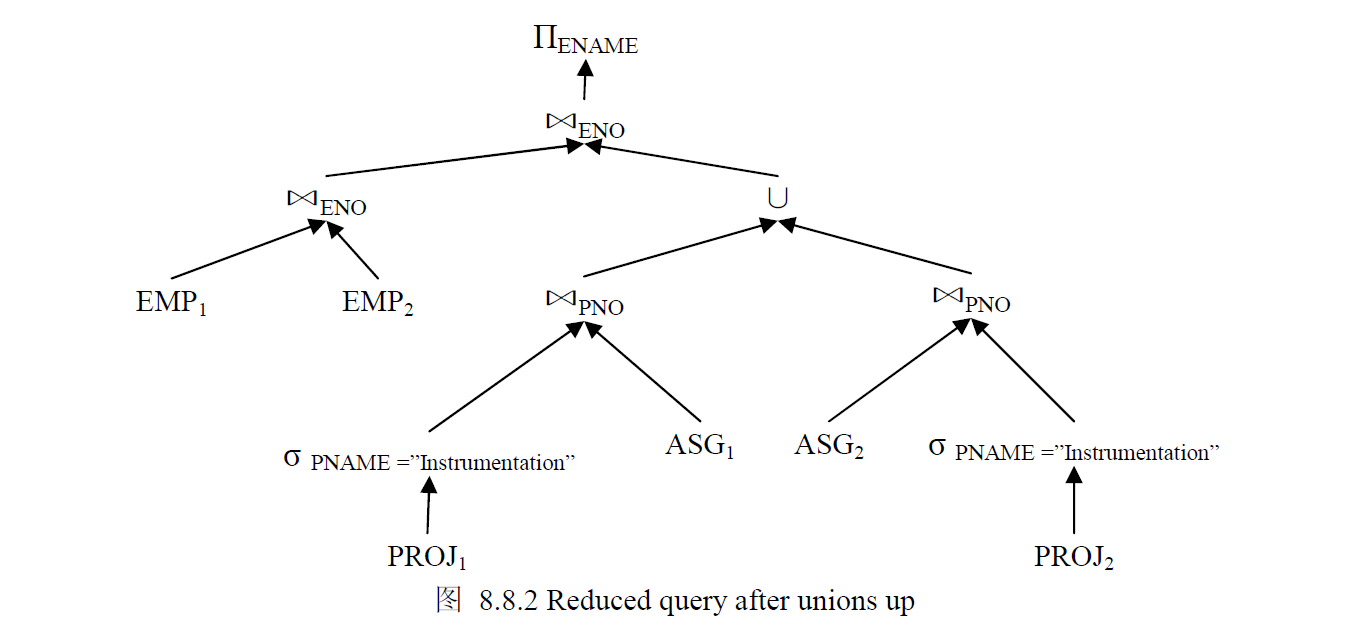
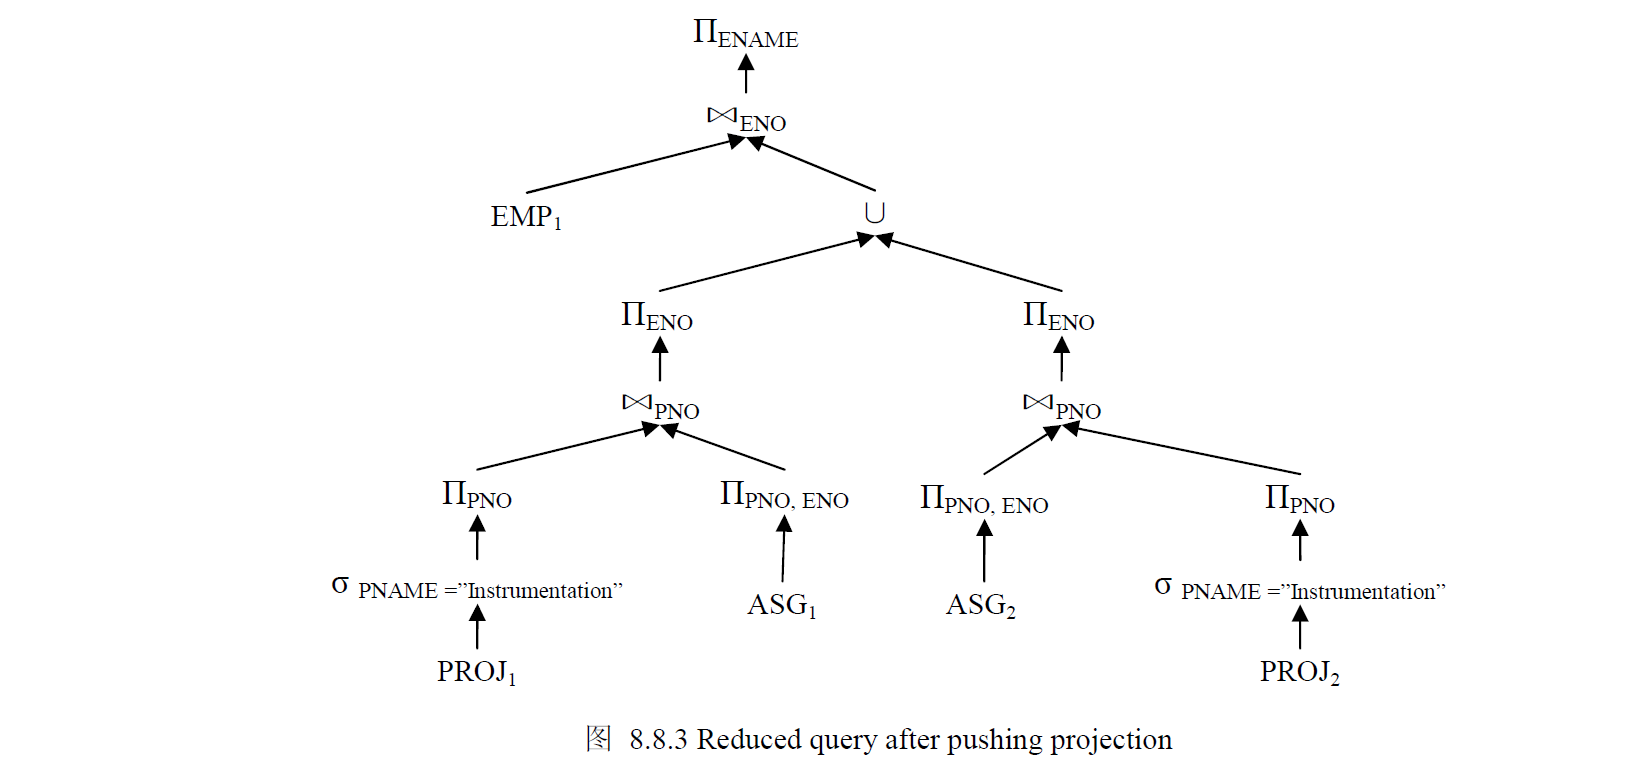
将以下查询转化为片段的简化查询:
SELECT ENAME |
方法:
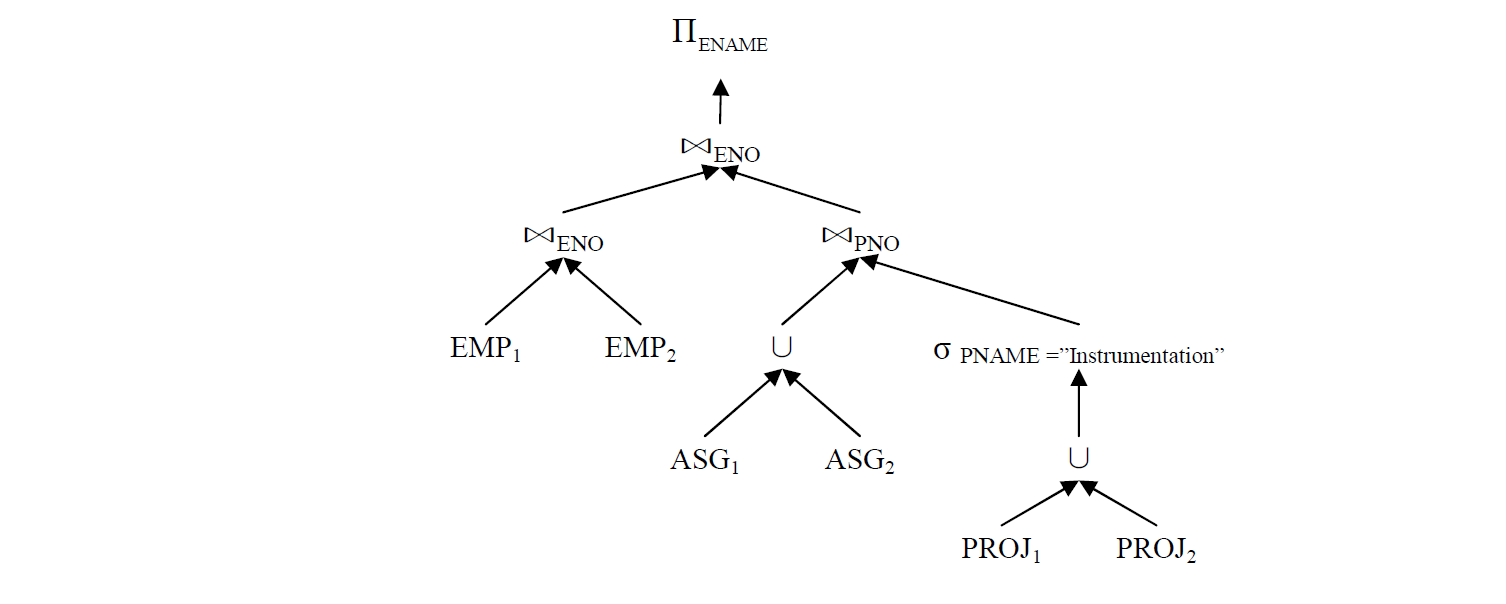
由一个元组演算查询向运算树的转换很容易通过下面的方法完成。首先,为每一个不同的元组变量(与一个关系对应)生成不同的叶子节点。在SQL语句里,叶子可以从FROM字句里直接得到。第二,用涉及结果属性的投影操作生成根节点,这可以从SQL的SELECT字句里得到。第三,将限定条件(SQL WHERE字句)翻译成从叶子到根之间的关系操作(选择,连结,并等操作)序列,这可以直接按照谓词和操作出现的顺序来生成。
答案:
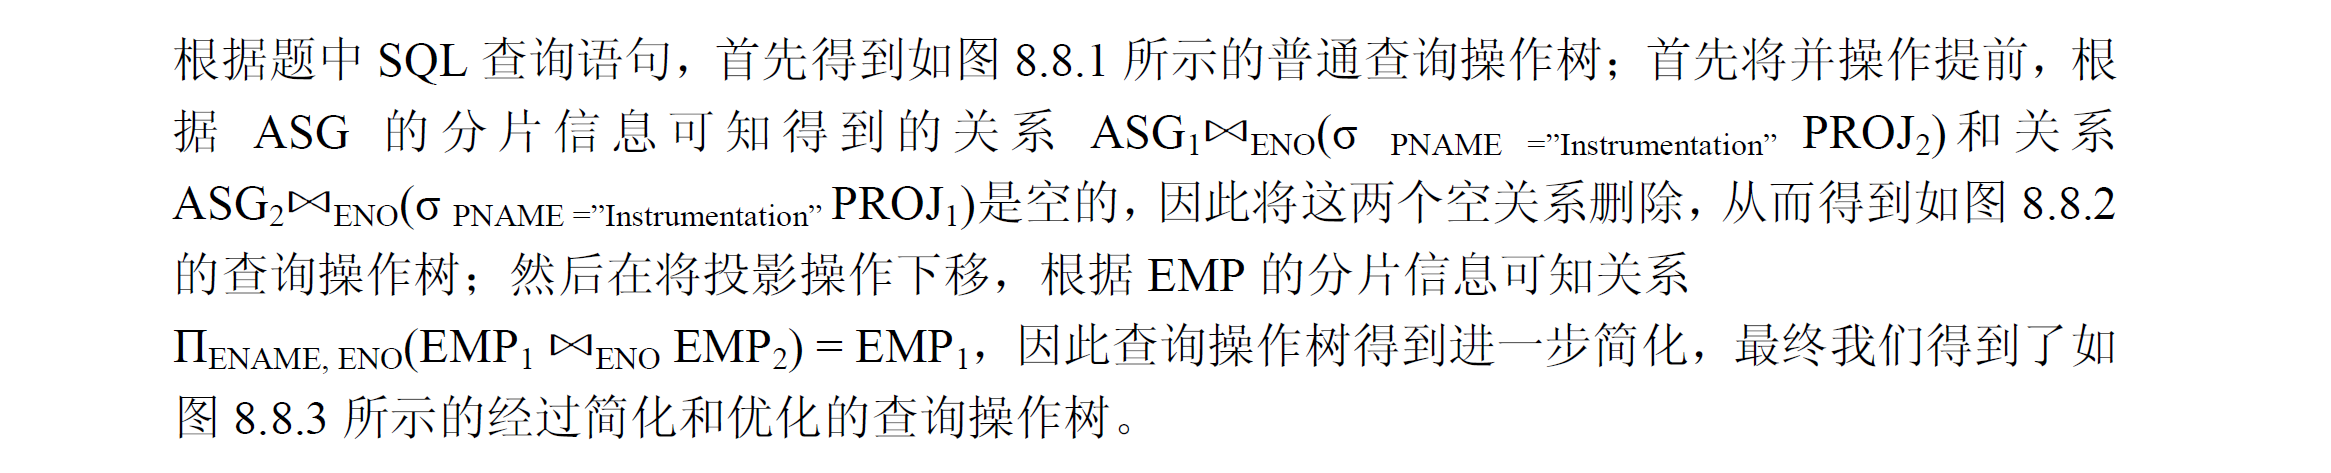
画图过程:先从分片关系里写他们的关系,是并集(水平分片)还是连结(垂直分片),然后是根据查询语句画本地化查询
归结
6 两步优化
例4.20
考虑以下用关系代数表示的查询Q:
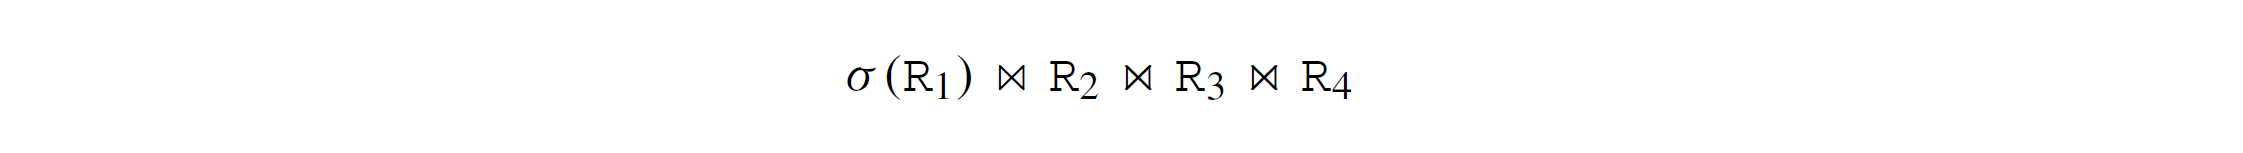
图4.16显示了4个关系的副本在4个站点上的放置以及站点负载。我们假设Q被分解为Q ={q1,q2,q3,q4},其中q1与R1相关联,q2与R2与q1的结果相关联,q3与R3与q2的结果相关联,并且q4与R4与q3的结果相关联。
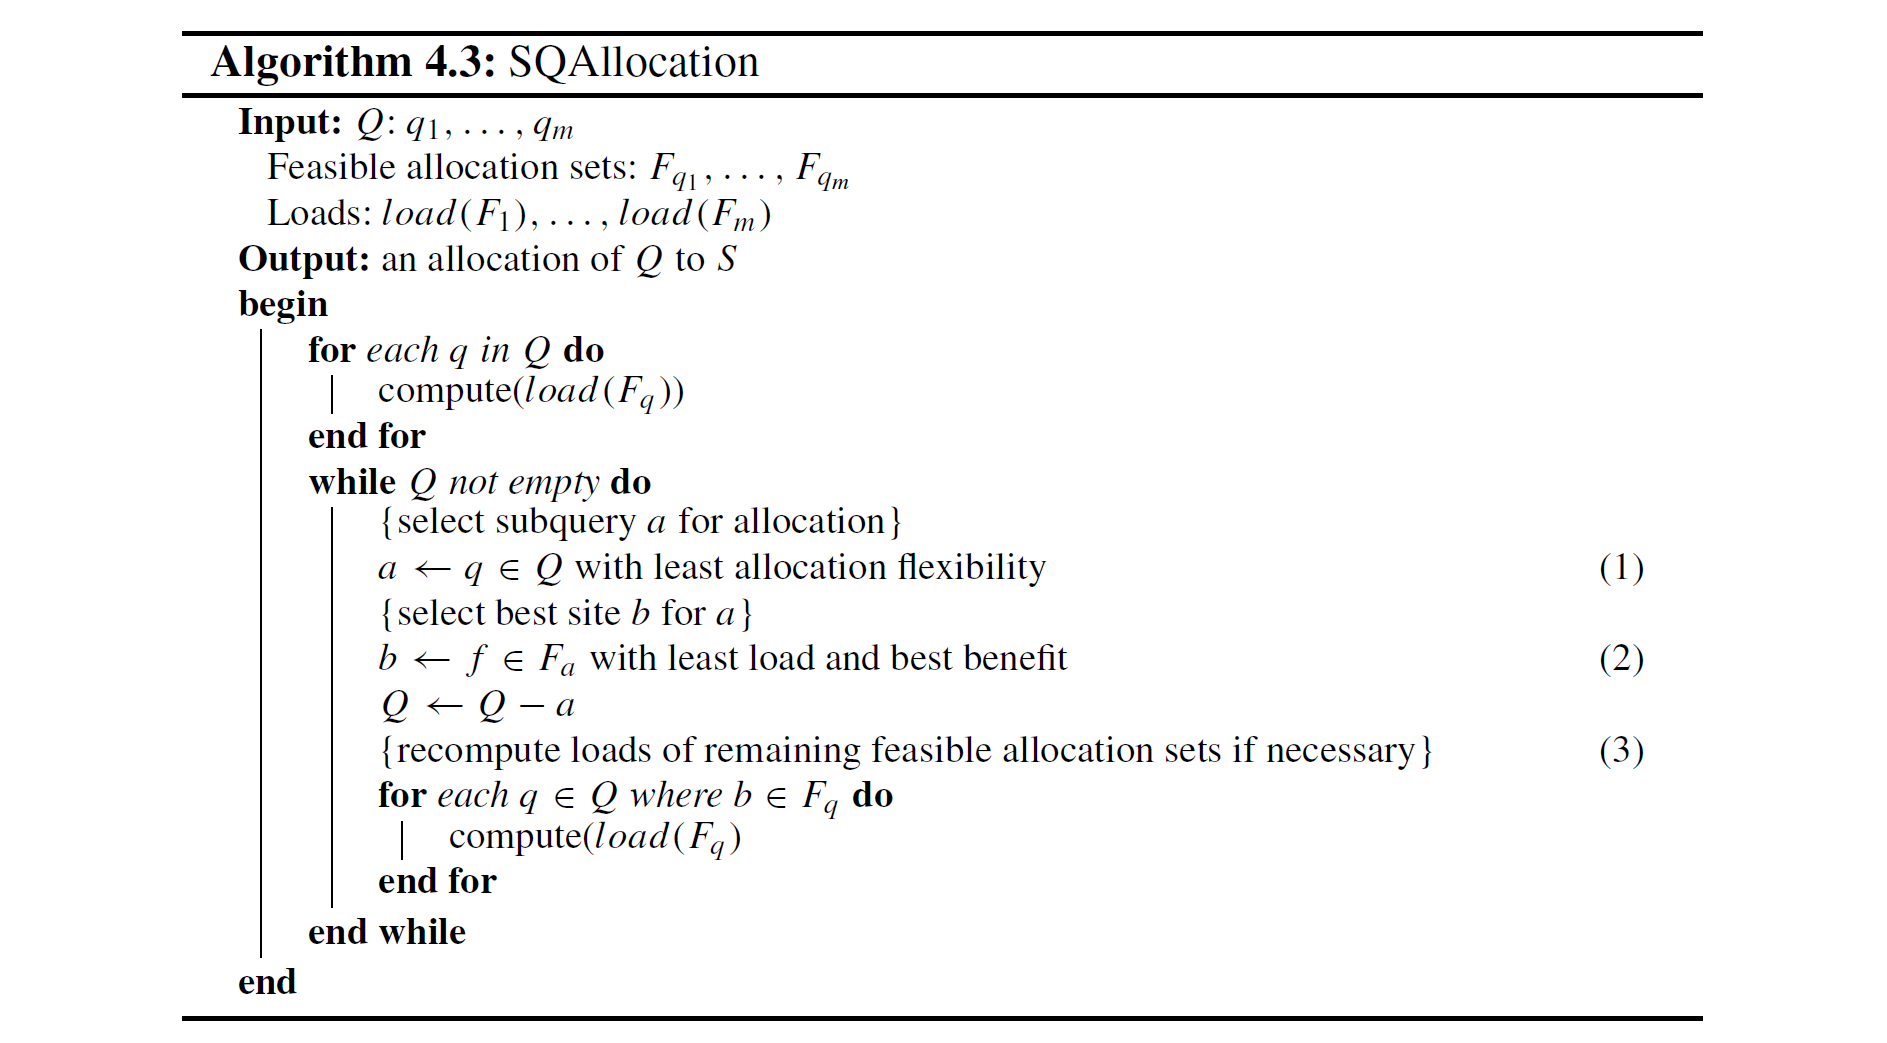
// 算法翻译 |
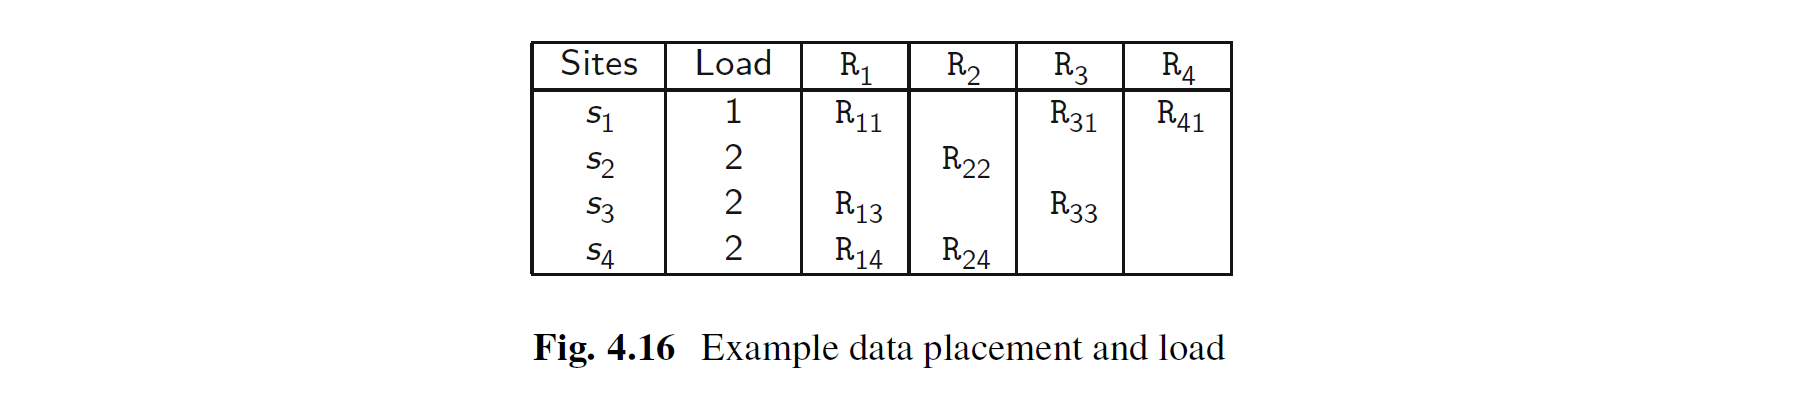
图4.16给出了4个关系的拷贝在4个站点上的放置以及站点负载。算法执行4次迭代。在第一次迭代中,它选择分配灵活性最低的q4,将其分配给S1,并更新S1的负载为2。在第二次迭代中,下一个要选择的子查询是q2或q3,因为它们具有相同的分配灵活性。假设我们选择q2,并假设它被分配给S2(它也可能被分配给S4,因为S4的负载与S2相同)。S2的负载增加到3。在第三次迭代中,选择的下一个子查询是q3,它被分配给S1,S1的负载与S3相同,但由于q4的分配,S1的效益为1(而S3的效益为0)。S1的负载增加到3。最后,在最后一次迭代中,q1被分配给S3或S4,它们的负载最低。如果在第二次迭代中q2被分配给S4而不是S2,那么第四次迭代就会将q1分配给S4,因为效益为1。这将产生一个更好的执行计划,通信量更少。这说明两步优化仍可能错过最优计划。
这个算法的复杂度合理。它依次考虑每个子查询,考虑每个潜在的站点,选择当前站点进行分配,并对剩余的子查询列表进行排序。因此,其复杂度可以表示为O(max(m n, m^2 log2m))。
最后,该算法包括一个细化阶段,以进一步优化连接处理并决定是否使用半连接。尽管它在给定静态计划的情况下最小化了通信,但两步查询优化可能会生成比最优计划具有更高通信成本的运行时计划。这是因为第一步在忽略数据位置及其对通信成本的影响的情况下进行的。例如,考虑图4.15中的运行时计划,假设对R3的第三个子查询被分配到站点S1(而不是站点S2)。在这种情况下,先在站点S1对R1的选择结果与R3进行连接(或笛卡尔积)的计划可能更好,因为它最小化了通信。解决这个问题的方法是在启动时使用操作符树变换进行计划重组。
最后分配完应该是这样的(不知道为什么PPT和书里为什么都没有最后的结果)
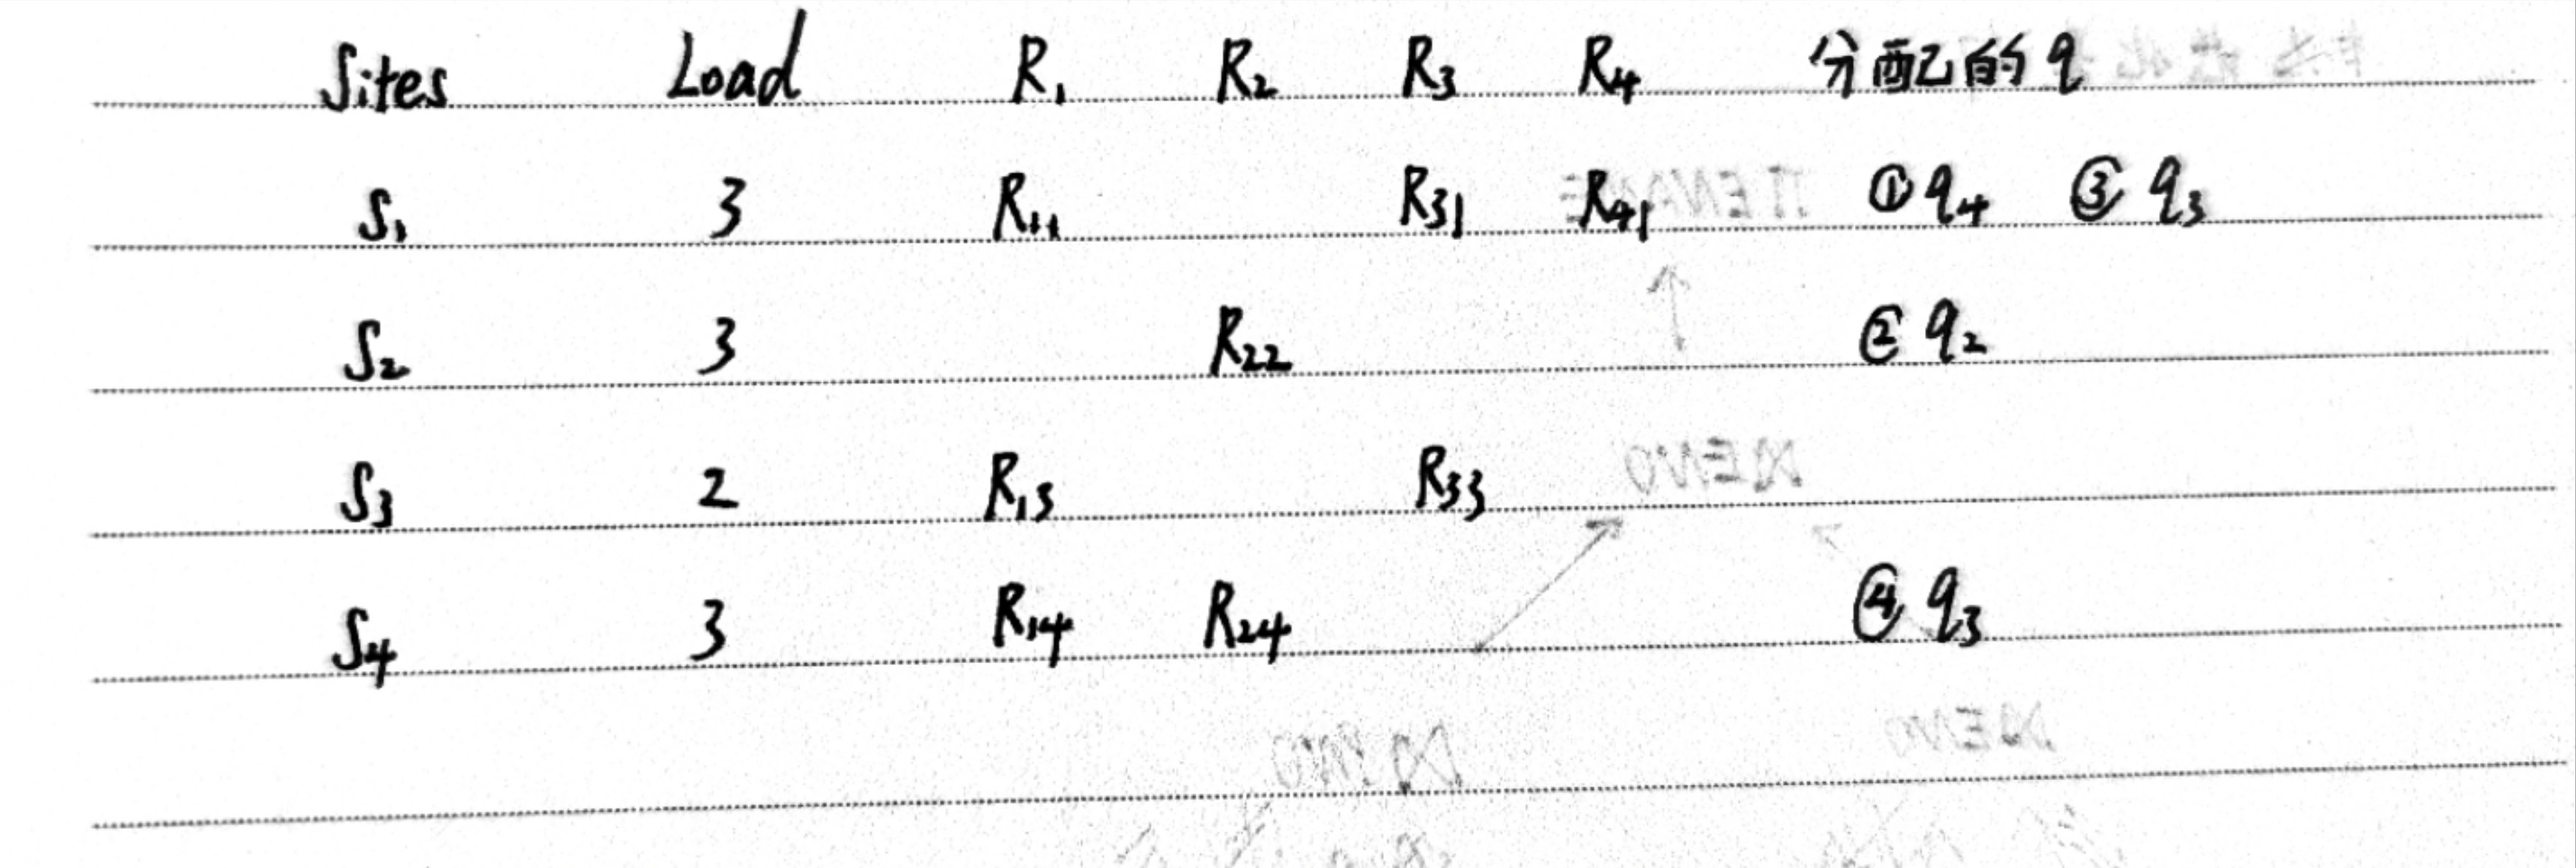
7 调度历史的等价判断
习题5.1
下列哪些历史是冲突等价的?
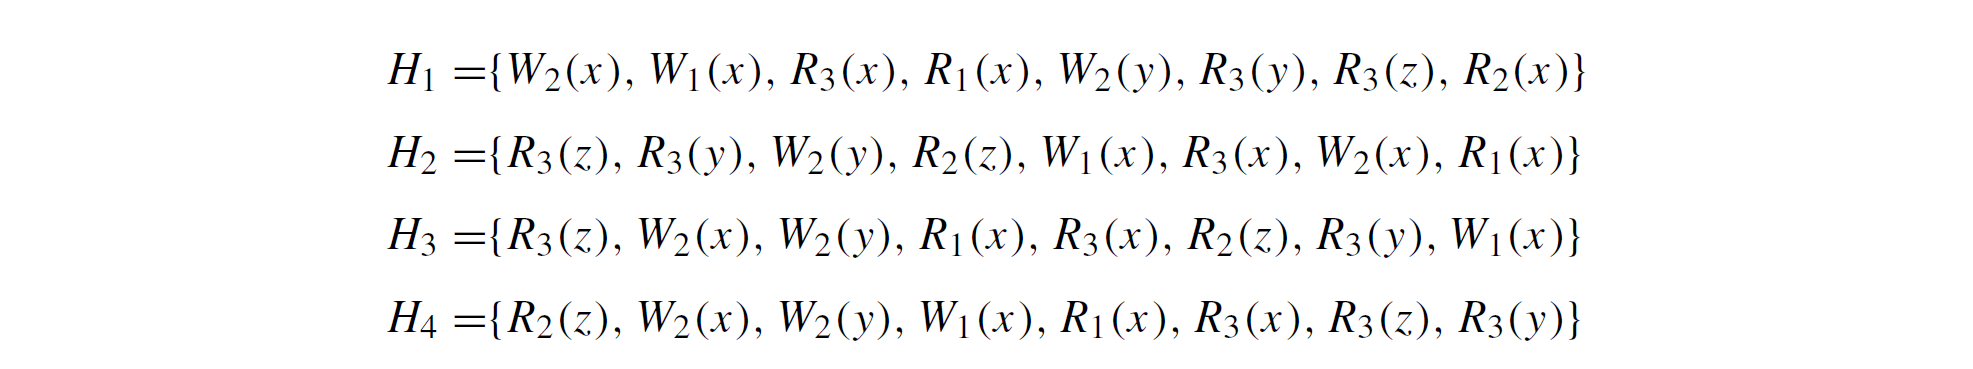
解题思路:
① 分别在每个历史中取出关于x、y、x的读写操作
② 取两个历史进行比较,取设计写操作(即W操作)进行两两比较,如果顺序完全一致,则两个历史为冲突等价
前人答案
H1:
- x:W2、W1、R3、R1、R2
- y:W2、R3
- z:R3
H2:
- x:W1、R3、W2、R1
- y:R3、W2
- z:R3、R2
H3:
- x:W2、R1、R3、W1
- y:W2、R3
- z:R3、R2
H4:
- x:W2、W1、R1、R3
- y:W2、R3
- z:R2、R3
两两比较,得出H1和H4是冲突等价的。
Chegg上的答案(感觉怎么是ChatGPT写的,我的0.5大洋啊)
冲突等价性是并发历史的一个属性,指具有相同操作集合和相同冲突集合的历史。如果两个历史代表了相同的一组合法结果,即一个历史的任何执行都可以在不违反任何冲突关系的情况下转换为另一个历史的执行,那么这两个历史就被称为是冲突等价的。换句话说,冲突等价的历史在其对共享状态的可观察效果方面是不可区分的。
序列化是将并发历史转换为等价的串行历史的过程,其中操作按照一种方式排序,使它们看起来像是一个接一个执行的,就好像它们是在单线程环境中执行的。如果一个串行历史保留了原始并发历史的冲突关系,那么它就被称为是合法的。
序列化图是一个有向图,表示并发历史的可能序列化。图的节点对应于历史中的操作,边表示它们之间的冲突。历史的序列化当且仅当序列化图没有循环时才是合法的。
在这个问题中,我们给出了四个并发历史,要求确定哪些是冲突等价的,哪些是可序列化的。要确定冲突等价性,我们需要比较每个历史中的操作集合和冲突,看它们是否相同,而不考虑它们出现的顺序。在这种情况下,我们可以看到H1、H2和H3具有相同的操作集合和冲突,而H4具有不同的操作集合和冲突,所以我们可以得出结论,H1、H2和H3是冲突等价的,但H4不是。
要确定可序列化性,我们需要为每个历史构造一个序列化图,并检查它是否有任何循环。思路是在图中对操作进行排序,使冲突的操作通过适当顺序的有向边连接。任何遵守这些边的有效操作排序都是历史的有效序列化。在这种情况下,我们可以为每个历史构造一个序列化图,并通过将图中的节点从左到右排序来找到有效的序列化,使边也从左到右指向。然后我们可以检查结果序列化图是否没有循环。如果有循环,那么这个历史就不是可序列化的。如果没有循环,那么这个历史就是可序列化的。
A) H1、H2和H3是冲突等价的。这可以通过观察到这三个历史涉及相同的读写操作集合,并且作用于相同的变量集合来看出,尽管它们的顺序不同。另一方面,H4涉及不同的操作和变量集合,因此与其他历史不冲突等价。
B) H1、H2、H3和H4都是可串行化的,因为它们可以通过构造序列化图转换为合法的串行顺序。要构造序列化图,我们可以从历史中先于另一个操作并与之冲突的操作画一条边到该操作。结果图应该没有循环。以下是这些历史的一种可能的序列化图:
W2(x) -> W1(x) -> R3(x) -> R1(x) -> W2(y) -> R3(y) -> R3(z) -> R2(x)
在这个序列化中,写操作W2(x)首先执行,接着是W1(x),因为W1(x)与W2(x)冲突,所以在串行顺序中必须在其之后。同样,R3(x)在W1(x)之后,因为它与W1(x)冲突,以此类推。其他可能的序列化也是有效的,只要它们不违反操作之间的冲突关系。
总结一下,我们分析了四个并发历史,并确定了哪些是冲突等价的,哪些是可序列化的:
H1、H2和H3是冲突等价的,因为它们涉及相同的操作集合和冲突,尽管顺序不同。H4与其他历史不冲突等价,因为它涉及不同的操作集合和冲突。
所有四个历史都是可序列化的,因为它们可以通过构造没有循环的序列化图转换为合法的串行顺序。所有四个历史的一种可能的序列化图是:
W2(x) -> W1(x) -> R3(x) -> R1(x) -> W2(y) -> R3(y) -> R3(z) -> R2(x)
在这个序列化中,操作根据它们的冲突进行排序,以便冲突的操作按正确的顺序执行。任何其他遵守冲突关系的有效序列化也是可以接受的。
8 两阶段提交
习题5.13(记忆题)
讨论使用分布式通信拓扑的2PC的站点故障终止协议
答案
协调者超时:协调者超时可能发生在三个状态中:WAIT、COMMIT 和 ABORT
- INITIAL超时
- 不需关注
- WAIT超时
- 不能单方面提交
- 可以单方面取消
- ABORT或COMMIT超时
- 向没有返回确认信息的参与者再次发送全局提交/取消信息
- 阻塞,等待确认
参与者超时:参与者超时可能发生在两个状态中:INITIAL和READY
- INITIAL超时
- 协调者一定在初始状态下故障
- 单方面取消
- 如果之后收到了prepare,采取以下之一措施
- 回复vote-abort
- 忽略prepare
READY超时
- 无法确定结果,阻塞
详细文字版
终结协议负责处理协调者和参与者进程的计时器超时事件。当目标站点不能在预计时间内从源站点处获得期望中的消息时,就会产生一个超时事件。
协调者超时:协调者超时可能发生在三个状态中:WAIT、COMMIT和ABORT。
(1)在WAIT状态下的超时。协调者未收到所有局部决策,有参与者故障。协调者可以单
方面取消,发送“global—abort”消息。
(2)在COMMIT和ABORT状态下的超时。有参与者故障,协调者未收到其ACK。协调者会
向其不停发送“global-commit”/“global-abort”等待其回应。
参与者超时:参与者超时可能发生在两个状态中:INITIAL和READY。
(1)在ITITIAL状态下的超时。协调者故障,参与者未等到“prepare”消息。此时参与者可
单方面取消。若取消后又收到“prepare”,要么回复“vote-abort”,要么忽略(这种情况
下协调者会在WAIT状态超时)。
(2)在READY状态下的超时。参与者未等到协调者的全局决策,协调者故障,此时它又不
被允许单方面取消。如果采用集中式通信,那么参与者会一直阻塞。
每个其他参与者可以这样响应:
①INITIAL状态:可单方面取消,故回复vote-abort;
②READY状态:回复自己是READY状态,无法帮助决策;
③ABORT/COMMIT状态:回复相应的global—abort/global-commit;
该参与者对收到的响应的处理:
①有任一参与者回复“vote-abort”,则自己也可abort;
②所有参与者“global—abort”或“global—commit”,则自己也进行相同的处理;
③所有参与者都处于READY状态,则大家可以一起选举一个新的协调者;
④若这个阶段有参与者和协调者同时发生故障,考虑极端情况。若协调者发送全局决策信息
后,发生了局部网络异常或故障,导致只有一个参与者收到并执行了全局决策,其他参与者
处于READY状态。然后这唯一的参与者发生了故障。此时其他参与者不知道它执行的是什
么,选举出来新的协调者做出的全局决策可能和故障参与者执行的决策不同,则会导致数据
不一致。可见无法设计2PC的非阻塞终结协议。
9 复制协议应用场合
习题6.1
对于四种复制协议(积极集中式,积极分布式,惰性集中式,惰性分布式)中的每一种,给予一个场景/应用程序,其中该方法比其他方法更适合。解释一下原因
答案(Claude写的)
- 积极集中式复制协议
场景:银行的在线交易系统
原因:在银行系统中,数据一致性和实时性至关重要。积极复制确保所有副本立即更新,而集中式控制有助于维护严格的一致性和事务顺序。这种方法可以防止诸如重复交易或账户余额不一致等问题。虽然可能会有一些性能开销,但在金融领域,数据的准确性和一致性比极高的吞吐量更重要。
- 积极分布式复制协议
场景:全球分布的社交媒体平台
原因:社交媒体平台需要在全球范围内快速传播用户更新,同时处理大量并发写操作。积极复制确保用户在任何位置都能看到最新的更新,而分布式方法允许在不同地理位置的数据中心之间进行更有效的协调,减少了中央协调者的瓶颈。这种方法可以提供良好的性能和一致性平衡,适合需要快速传播信息但可以容忍短暂不一致的应用。
- 惰性集中式复制协议
场景:内容分发网络(CDN)
原因:CDN主要处理读取操作,而写操作相对较少。惰性复制允许内容在被请求时才更新到各个节点,这对于CDN来说非常高效,因为并非所有内容都会在所有位置被访问。集中式控制有助于管理哪些内容需要更新,以及何时更新。这种方法可以显著减少网络流量和存储成本,同时仍能提供良好的用户体验。
- 惰性分布式复制协议
场景:分布式版本控制系统(如Git)
原因:在版本控制系统中,每个用户都有完整的本地副本,而且大多数操作都是本地的。只有在用户明确要求时(如push或pull操作),才会进行副本间的同步。惰性复制非常适合这种情况,因为它允许用户在本地工作,而不需要持续的网络连接。分布式方法使得每个副本都可以独立工作,没有中央控制点,这与Git的分布式特性非常匹配。这种方法提供了极大的灵活性和离线工作能力,同时在需要时仍能实现副本间的同步。
10 终结协议
习题6.4
考虑跨站点复制的数据项x和y如下:

(a) 为每个站点分配投票,并给予读写法定人数。
(b) 确定网络可以分区的可能方式,并为每个分区指定在哪个站点组中可以终止更新(读取和写入)x的事务以及终止条件。
(c) 对y重复(b)。
答案
网上搜的,我感觉答案不对
(a) 假设有n个站点。为每个站点 i 分配 vi 票数,使得总票数 V 为:
读法定人数 Qr 和写法定人数 Qw 必须满足以下条件:
(b)
(c)
Claude写的,还有点道理
(a) 为每个站点分配投票,并给予读写法定人数:
首先,我们需要分配投票权重。通常,我们会根据数据项的分布来分配投票。
对于x: Site 1: 1票 Site 2: 1票 Site 4: 1票 总票数:3票
对于y: Site 2: 1票 Site 3: 1票 Site 4: 1票 总票数:3票
法定人数设置: 读取法定人数(RQ)+ 写入法定人数(WQ)> 总票数 为了保证一致性,我们可以设置: RQ = 2, WQ = 2
这样确保了读写操作的一致性,同时允许一定程度的并行性。
(b) 对x的网络分区分析:
可能的分区方式:
- {Site 1}, {Site 2, Site 3, Site 4}
- {Site 2}, {Site 1, Site 3, Site 4}
- {Site 4}, {Site 1, Site 2, Site 3}
- {Site 1, Site 2}, {Site 3, Site 4}
- {Site 1, Site 4}, {Site 2, Site 3}
- {Site 2, Site 4}, {Site 1, Site 3}
可以终止x更新的分区:
- {Site 1, Site 2}:2票,满足写入法定人数
- {Site 1, Site 4}:2票,满足写入法定人数
- {Site 2, Site 4}:2票,满足写入法定人数
- {Site 1, Site 2, Site 4}:3票,满足写入法定人数
终止条件:分区中的站点总票数 >= 写入法定人数(2票)
(c) 对y的网络分区分析:
可能的分区方式:
- {Site 2}, {Site 1, Site 3, Site 4}
- {Site 3}, {Site 1, Site 2, Site 4}
- {Site 4}, {Site 1, Site 2, Site 3}
- {Site 2, Site 3}, {Site 1, Site 4}
- {Site 2, Site 4}, {Site 1, Site 3}
- {Site 3, Site 4}, {Site 1, Site 2}
可以终止y更新的分区:
- {Site 2, Site 3}:2票,满足写入法定人数
- {Site 2, Site 4}:2票,满足写入法定人数
- {Site 3, Site 4}:2票,满足写入法定人数
- {Site 2, Site 3, Site 4}:3票,满足写入法定人数
终止条件:分区中的站点总票数 >= 写入法定人数(2票)